
LODEX s’appuie sur Vega-Lite, une grammaire de visualisation déclarative, pour générer la plupart de ses graphiques. Grâce à ce langage, il est possible de personnaliser les visualisations proposées par LODEX, mais aussi de créer des représentations plus avancées adaptées à la structure de vos données.

|

|

|

|

|

|

|

|
Qu’il s’agisse de modifier les couleurs, les polices, les axes, les légendes, les infobulles ou les étiquettes, de combiner plusieurs représentations ou encore de construire un nouveau type de graphique, Vega-Lite permet d’aller au-delà des paramètres proposés directement dans l’interface.
Cette section rassemble des modèles de graphiques Vega-Lite prêts à être adaptés et réutilisés dans LODEX. Chaque modèle part d’un besoin de visualisation concret et présente la configuration nécessaire pour obtenir le résultat souhaité.
Certains modèles permettent de personnaliser un graphique existant, tandis que d’autres proposent des visualisations plus élaborées, comme des graphiques combinés, des barres empilées, des aires superposées ou des cercles imbriqués. Lorsque cela est nécessaire, la préparation des données à l’aide d’une routine LODEX est également expliquée.
Aucune connaissance approfondie de Vega-Lite n’est nécessaire pour utiliser ces modèles. Les scripts proposés peuvent être copiés puis adaptés à vos propres données en suivant les indications fournies pour chaque modèle. Ils permettent également de se familiariser progressivement avec la structure d’une spécification Vega-Lite.
Activer le Mode avancé
Pour accéder à la configuration complète d’un graphique, commencez par activer le Mode avancé dans les paramètres du format. Ce mode permet d’éditer directement la spécification Vega-Lite du graphique et de personnaliser son apparence ainsi que son comportement.

Tous les modèles présentés dans cette section nécessitent que le Mode avancé soit activé.
L’activation du Mode avancé ne modifie pas le fonctionnement du graphique. Elle permet simplement d’accéder à sa spécification Vega-Lite. Vous pouvez revenir à tout moment à la configuration précédente en désactivant ce mode.
Diagramme à barres colorées par catégories
Le diagramme à barres est particulièrement adapté pour comparer les effectifs de plusieurs catégories. L’utilisation d’une couleur différente pour chaque catégorie permet de les distinguer rapidement et de faciliter la lecture du graphique.
Dans cet exemple, le graphique permet de visualiser la répartition des publications d’un corpus selon leur voie d’accès à la science ouverte : Diamond, Gold, Green, Bronze, Hybrid ou Closed.
Configurer la routine
Dans cet exemple, les données sont préparées à l’aide de la routine distinct-by.
La routine est appliquée au champ contenant les voies d’accès. Elle permet de compter le nombre de publications correspondant à chaque valeur du champ.

Elle produit automatiquement une structure de données contenant deux champs :
{
  "_id": "Gold",
  "value": 577
}
- _id : la catégorie à représenter, ici la voie d’accès.
- value : le nombre de publications correspondant à cette catégorie.
Cette structure est directement exploitable par Vega-Lite pour représenter chaque catégorie sous la forme d’une barre dont la hauteur correspond à son nombre de publications.
Créer le graphique
Le script suivant attribue une couleur différente à chaque voie d’accès. Il calcule également la part représentée par chaque catégorie dans l’ensemble des publications. Cette valeur est stockée dans le champ Taux et affichée dans l’infobulle sous l’intitulé Taux de publication.
{
  "transform": [
    {
      "window": [
        {
          "op": "sum",
          "field": "value",
          "as": "NbPublisPerYear"
        }
      ],
      "frame": [
        null,
        null
      ]
    },
    {
      "calculate": "round(datum.value*1000/datum.NbPublisPerYear)/1000",
      "as": "Taux"
    }
  ],
  "layer": [
    {
      "mark": {
        "type": "bar"
      },
      "encoding": {
        "x": {
          "field": "_id",
          "type": "nominal",
          "axis": {
            "labelAngle": 0,
            "tickMinStep": 1
          },
          "title": "",
          "sort": [
            "Diamond",
            "Gold",
            "Green",
            "Bronze",
            "Hybrid",
            "Closed"
          ]
        },
        "y": {
          "field": "value",
          "type": "quantitative",
          "axis": {
            "labelAngle": 0,
            "tickMinStep": 1
          },
          "scale": {
            "type": "linear"
          },
          "title": ""
        },
        "color": {
          "field": "_id",
          "scale": {
            "domain": [
              "Diamond",
              "Gold",
              "Green",
              "Bronze",
              "Hybrid",
              "Closed"
            ],
            "range": [
              "#00bfff",
              "#f9bc01",
              "#228B22",
              "#c97522",
              "#ffff67",
              "#7f7f7f"
            ]
          },
          "type": "nominal",
          "legend": null
        },
        "tooltip": [
          {
            "field": "_id",
            "type": "nominal",
            "title": "Voie d'accès"
          },
          {
            "field": "value",
            "type": "quantitative",
            "title": "Nb publis"
          },
          {
            "field": "Taux",
            "title": "Taux de publication",
            "format": ".1%",
            "type": "quantitative"
          }
        ],
        "size": {
          "value": 50
        }
      }
    },
    {
      "mark": {
        "type": "text",
        "color": "black",
        "fontSize": 10,
        "fontWeight": "bold",
        "baseline": "bottom",
        "align": "center",
        "dx": 0
      },
      "encoding": {
        "x": {
          "field": "_id",
          "type": "nominal",
          "title": "",
          "sort": [
            "diamond",
            "gold",
            "green",
            "bronze",
            "hybrid",
            "closed"
          ]
        },
        "y": {
          "field": "value",
          "type": "quantitative",
          "axis": null
        },
        "text": {
          "field": "value",
          "type": "quantitative"
        }
      }
    }
  ],
  "padding": {
    "left": 0,
    "right": 0,
    "top": 0,
    "bottom": 0
  },
  "config": {
    "view": {
      "strokeWidth": 0
    }
  },
  "width": 600,
  "height": 300
}
Adapter le graphique à vos données
Cette recette peut être utilisée avec d’autres catégories. Les valeurs et les couleurs associées sont définies dans les propriétés domain et range :
"scale": {
  "domain": [
    "Diamond",
    "Gold",
    "Green",
    "Bronze",
    "Hybrid",
    "Closed"
  ],
  "range": [
    "#00bfff",
    "#f9bc01",
    "#228B22",
    "#c97522",
    "#ffff67",
    "#7f7f7f"
  ]
}
Chaque valeur du tableau domain correspond à la couleur située à la même position dans le tableau range. Vous pouvez donc remplacer les catégories et les couleurs par celles adaptées à vos propres données.
Pensez également à adapter l’ordre des catégories défini dans la propriété sort :
"sort": [
  "Diamond",
  "Gold",
  "Green",
  "Bronze",
  "Hybrid",
  "Closed"
]
_id et value. Vous pouvez ainsi représenter des types de documents, des disciplines, des établissements, des pays ou toute autre catégorie présente dans votre jeu de données.
Graphiques combinés : diagramme à barres et graphique en courbes
Les graphiques combinés permettent de représenter plusieurs informations dans une même visualisation en associant différents types de représentations.
Dans cet exemple, un diagramme à barres indique le nombre total de publications par année, tandis que plusieurs courbes permettent de visualiser leur répartition selon leur voie d’accès à la science ouverte.
Configurer la routine
Dans cet exemple, les données sont préparées à l’aide de la routine pairing-with.
La routine est appliquée à deux champs :
- Champ source : l’année de publication ;
- Champ cible : la voie d’accès à la science ouverte.

La routine produit une structure de données contenant trois champs :
{
  "source": "2023",
  "target": "Gold",
  "weight": 42
}
- source : la première dimension, ici l’année de publication ;
- target : la seconde dimension, ici la voie d’accès ;
- weight : le nombre de publications correspondant à cette combinaison.
Cette structure permet de représenter simultanément le nombre total de publications par année et leur répartition selon les différentes voies d’accès.
Créer le graphique
Le script suivant combine plusieurs couches Vega-Lite. Les barres représentent le nombre de publications par année, tandis que les courbes et leurs points représentent les différentes voies d’accès.
{
  "background": "transparent",
  "padding": 40,
  "width": "container",
  "height": "container",
  "autosize": {
    "type": "fit",
    "contains": "padding"
  },
  "transform": [
    {
      "window": [
        {
          "op": "sum",
          "field": "weight",
          "as": "NbDocsParAnnnées"
        }
      ],
      "groupby": [
        "source"
      ],
      "frame": [
        null,
        null
      ]
    }
  ],
  "layer": [
    {
      "mark": {
        "type": "bar"
      },
      "encoding": {
        "x": {
          "field": "source",
          "type": "nominal",
          "axis": {
            "labelAngle": 0,
            "labelOverlap": true,
            "tickMinStep": 1
          },
          "title": "",
          "sort": null
        },
        "y": {
          "field": "weight",
          "type": "quantitative",
          "axis": {
            "labelAngle": 0,
            "tickMinStep": 1
          },
          "scale": {
            "type": "linear"
          },
          "title": "",
          "sort": null
        },
        "color": {
          "value": "#1f77b4"
        },
        "tooltip": [
          {
            "field": "source",
            "type": "nominal",
            "title": "Années"
          },
          {
            "field": "NbDocsParAnnnées",
            "type": "quantitative",
            "title": "Nombre de publications"
          }
        ],
        "size": {
          "value": 60
        }
      }
    },
    {
      "mark": {
        "type": "line",
        "point": true
      },
      "encoding": {
        "x": {
          "field": "source",
          "type": "nominal",
          "axis": {
            "labelAngle": 0,
            "labelOverlap": true
          },
          "title": "Années",
          "sort": "x"
        },
        "y": {
          "field": "weight",
          "type": "quantitative",
          "axis": {
            "labelAngle": 0
          },
          "scale": {
            "type": "linear"
          },
          "title": "Nombre de documents"
        },
        "color": {
          "field": "target",
          "title": "Voie d'accès",
          "scale": {
            "domain": [
              "Diamond",
              "Gold",
              "Green",
              "Bronze",
              "Hybrid",
              "Closed"
            ],
            "range": [
              "#00bfff",
              "#f9bc01",
              "#228B22",
              "#c97522",
              "#ffff67",
              "#7f7f7f"
            ]
          },
          "type": "nominal"
        },
        "data": {
          "name": "values"
        },
        "tooltip": [
          {
            "field": "NbDocsParAnnnées",
            "title": "N Docs de l'année",
            "type": "quantitative"
          },
          {
            "field": "target",
            "type": "nominal",
            "title": "Voie d'accès"
          },
          {
            "field": "weight",
            "type": "quantitative",
            "title": "Nb Docs Année / Statut OA"
          }
        ],
        "mark": {
          "type": "text",
          "color": "darkblue",
          "fontSize": 10,
          "fontWeight": "bold",
          "baseline": "bottom",
          "align": "center",
          "sort": "target",
          "dx": 0,
          "dy": -5
        },
        "encoding": {
          "x": {
            "field": "source",
            "type": "nominal",
            "title": "",
            "sort": "x"
          },
          "y": {
            "line": {
              "field": "target",
              "type": "quantitative"
            }
          }
        }
      }
    },
    {
      "mark": {
        "type": "text",
        "color": "black",
        "fontSize": 20,
        "fontWeight": "bold",
        "baseline": "bottom",
        "align": "center",
        "dx": 0,
        "dy": -5
      },
      "encoding": {
        "x": {
          "field": "source",
          "type": "nominal",
          "title": "",
          "sort": null
        },
        "y": {
          "field": "NbDocsParAnnnées",
          "type": "quantitative",
          "axis": {
            "labelAngle": 0,
            "tickMinStep": 1
          },
          "scale": {
            "type": "linear"
          },
          "sort": null
        },
        "text": {
          "field": "NbDocsParAnnnées",
          "type": "quantitative"
        }
      }
    }
  ]
}
Adapter le graphique à vos données
Ce modèle peut être adapté en modifiant plusieurs propriétés du script.
Modifier les couleurs
Les catégories et les couleurs des différentes courbes sont définies dans les propriétés domain et range :
"scale": {
  "domain": [
    "Diamond",
    "Gold",
    "Green",
    "Bronze",
    "Hybrid",
    "Closed"
  ],
  "range": [
    "#00bfff",
    "#f9bc01",
    "#228B22",
    "#c97522",
    "#ffff67",
    "#7f7f7f"
  ]
}
Chaque valeur du tableau domain correspond à la couleur située à la même position dans le tableau range.
Modifier la taille des éléments
La largeur des barres peut être modifiée en adaptant la propriété size :
"size": {
  "value": 60
}
La taille des textes peut quant à elle être modifiée à l’aide de la propriété fontSize des marques de type text.
Remplacer les courbes par des points
Il est également possible de supprimer les lignes reliant les points afin d’obtenir un graphique combinant un diagramme à barres et un nuage de points.
Pour cela, remplacez :
"mark": {
  "type": "line",
  "point": true
}
par :
"mark": {
  "type": "circle"
}
Vous obtiendrez alors une variante de type bar chart + scatterplot :

source, target et weight.
Donut
Le donut permet de représenter la répartition de plusieurs catégories au sein d’un ensemble. L’affichage direct des valeurs sur le graphique facilite la lecture en évitant de devoir consulter uniquement les infobulles.
Dans cet exemple, le graphique permet de visualiser la répartition des publications d’un corpus selon leur voie d’accès à la science ouverte. Chaque voie d’accès est représentée par une couleur différente et le nombre de publications correspondant est affiché directement autour du donut.
Configurer la routine
Dans cet exemple, les données sont préparées à l’aide de la routine distinct-by.
La routine est appliquée au champ contenant les voies d’accès. Elle permet de compter le nombre de publications correspondant à chaque valeur du champ.

Elle produit une structure de données contenant deux champs :
{
  "_id": "gold",
  "value": 577
}
- _id : la catégorie à représenter, ici la voie d’accès ;
- value : le nombre de publications correspondant à cette catégorie.
Cette structure est directement exploitable par Vega-Lite pour déterminer la taille de chaque portion du donut.
Créer le graphique
Le script suivant construit le donut à partir des valeurs produites par la routine. Il calcule également la proportion représentée par chaque catégorie afin de l’afficher dans l’infobulle sous l’intitulé Taux de publication.
{
  "$schema": "https://vega.github.io/schema/vega-lite/v5.json",
  "width": "container",
  "height": 450,
  "transform": [
    {
      "joinaggregate": [
        {
          "op": "sum",
          "field": "value",
          "as": "total"
        }
      ]
    },
    {
      "calculate": "datum.value / datum.total",
      "as": "proportion"
    },
    {
      "window": [
        {
          "op": "rank",
          "as": "rank"
        }
      ],
      "sort": [
        {
          "field": "value",
          "order": "descending"
        }
      ]
    },
    {
      "calculate": "datum.rank - 1",
      "as": "rank_minus_1"
    },
    {
      "calculate": "format(datum.value, ',.0f')",
      "as": "texte"
    }
  ],
  "layer": [
    {
      "mark": {
        "type": "arc",
        "innerRadius": 130
      },
      "encoding": {
        "theta": {
          "field": "value",
          "type": "quantitative",
          "stack": true
        },
        "color": {
          "field": "_id",
          "type": "nominal",
          "legend": {
            "orient": "right",
            "title": "Voie d'accès",
            "columns": 1
          },
          "scale": {
            "domain": [
              "gold",
              "unknown",
              "bronze",
              "hybrid",
              "closed"
            ],
            "range": [
              "#FFC40C",
              "#C0C0C0",
              "#CD7F32",
              "#EC5800",
              "#E23D28"
            ]
          }
        },
        "tooltip": [
          {
            "field": "_id",
            "type": "nominal",
            "title": "Voie d'accès"
          },
          {
            "field": "value",
            "type": "quantitative",
            "title": "Nb publis",
            "format": ",.0f"
          },
          {
            "field": "proportion",
            "type": "quantitative",
            "title": "Taux de publication",
            "format": ".1%"
          }
        ],
        "order": {
          "field": "rank_minus_1"
        }
      }
    },
    {
      "mark": {
        "type": "text",
        "fill": "black",
        "radius": 250,
        "fontSize": 14
      },
      "encoding": {
        "theta": {
          "field": "value",
          "type": "quantitative",
          "stack": true
        },
        "text": {
          "field": "texte"
        },
        "color": {
          "field": "_id",
          "type": "nominal"
        },
        "order": {
          "field": "rank_minus_1"
        }
      }
    }
  ],
  "view": {
    "stroke": null
  },
  "background": "transparent"
}
Adapter le graphique à vos données
Les catégories et les couleurs qui leur sont associées sont définies dans les propriétés domain et range :
"scale": {
  "domain": [
    "gold",
    "unknown",
    "bronze",
    "hybrid",
    "closed"
  ],
  "range": [
    "#FFC40C",
    "#C0C0C0",
    "#CD7F32",
    "#EC5800",
    "#E23D28"
  ]
}
Chaque valeur du tableau domain correspond à la couleur située à la même position dans le tableau range. Ces valeurs peuvent être remplacées par les catégories et les couleurs correspondant à votre propre jeu de données.
Modifier la taille du donut
La taille de l’espace central du donut est définie par la propriété innerRadius :
"innerRadius": 130
Une valeur plus élevée agrandit le trou central, tandis qu’une valeur plus faible rapproche le graphique d’un diagramme circulaire classique.
Modifier l’affichage des valeurs
Les valeurs affichées autour du donut sont positionnées à l’aide de la propriété radius de la marque de type text :
"radius": 250,
"fontSize": 14
Vous pouvez modifier radius pour rapprocher ou éloigner les valeurs du centre du graphique et fontSize pour ajuster leur taille.
_id et value. Elle n’est donc pas limitée aux voies d’accès à la science ouverte.
Graphique en cercles imbriqués
Le graphique en cercles imbriqués (nested ou concentric circles) permet de représenter deux niveaux de catégories dans une même visualisation. Le cercle intérieur présente les catégories principales, tandis que le cercle extérieur détaille les sous-catégories qui leur sont associées.
Par exemple, il peut être utilisé pour représenter la part de publications en Open Access ou non, puis détailler les différentes voies d’ouverture : Diamond, Gold, Green, Bronze, Hybrid ou Closed.
Configurer la routine
Dans cet exemple, les données sont préparées à l’aide de la routine pairing-with.
La routine prend en entrée deux champs :

- Champ source : Open Access, avec par exemple les valeurs
OuietNon. - Champ cible : Voie d’ouverture, avec par exemple les valeurs
Diamond,Gold,Green,Bronze,HybridetClosed.
Elle produit automatiquement une structure de données contenant trois champs :
{
  "source": "Oui",
  "target": "Diamond",
  "weight": 120
}
- source : la catégorie principale, représentée dans le cercle intérieur.
- target : la sous-catégorie, représentée dans le cercle extérieur.
- weight : le nombre de documents correspondant à chaque couple
source/target.
Un résultat de routine peut par exemple contenir les données suivantes :
[
  {
    "source": "Oui",
    "target": "Diamond",
    "weight": 120
  },
  {
    "source": "Oui",
    "target": "Gold",
    "weight": 80
  },
  {
    "source": "Oui",
    "target": "Green",
    "weight": 50
  },
  {
    "source": "Oui",
    "target": "Bronze",
    "weight": 30
  },
  {
    "source": "Oui",
    "target": "Hybrid",
    "weight": 20
  },
  {
    "source": "Non",
    "target": "Closed",
    "weight": 70
  }
]
Dans cet exemple, les valeurs Diamond, Gold, Green, Bronze et Hybrid sont rattachées à Oui, tandis que Closed est rattaché à Non.
Cette relation est importante : elle permet d’aligner les portions des deux cercles. La somme des sous-catégories appartenant à une même valeur de source détermine automatiquement la taille de cette catégorie dans le cercle intérieur.
Créer le graphique
Le script suivant construit les deux cercles à partir des relations entre les catégories source et target. La taille des portions est déterminée par le champ weight.
{
  "$schema": "https://vega.github.io/schema/vega-lite/v6.json",
  "background": "transparent",
  "width": "container",
  "height": "container",
  "padding": 20,
  "transform": [
    {
      "calculate": "toNumber(datum.weight)",
      "as": "value"
    },
    {
      "filter": "isValid(datum.value) && datum.value > 0"
    },
    {
      "joinaggregate": [
        {
          "op": "sum",
          "field": "value",
          "as": "grandTotal"
        }
      ]
    },
    {
      "calculate": "datum.value / datum.grandTotal",
      "as": "targetPercent"
    },
    {
      "calculate": "format(datum.targetPercent, '.1%')",
      "as": "targetPercentLabel"
    },
    {
      "calculate": "datum.targetPercent >= 0.04 ? datum.target : ''",
      "as": "targetVisibleLabel"
    },
    {
      "calculate": "datum.targetPercent >= 0.04 ? format(datum.targetPercent, '.1%') : ''",
      "as": "targetVisiblePercent"
    },
    {
      "calculate": "datum.source === 'Oui' ? 1 : datum.source === 'Non' ? 2 : 99",
      "as": "sourceOrder"
    },
    {
      "calculate": "datum.target === 'Diamond' ? 1 : datum.target === 'Gold' ? 2 : datum.target === 'Green' ? 3 : datum.target === 'Bronze' ? 4 : datum.target === 'Hybrid' ? 5 : datum.target === 'Closed' ? 6 : 99",
      "as": "targetOrder"
    }
  ],
  "layer": [
    {
      "transform": [
        {
          "aggregate": [
            {
              "op": "sum",
              "field": "value",
              "as": "sourceTotal"
            },
            {
              "op": "max",
              "field": "grandTotal",
              "as": "grandTotal"
            },
            {
              "op": "min",
              "field": "sourceOrder",
              "as": "sourceOrder"
            }
          ],
          "groupby": [
            "source"
          ]
        },
        {
          "calculate": "datum.sourceTotal / datum.grandTotal",
          "as": "sourcePercent"
        },
        {
          "calculate": "format(datum.sourcePercent, '.1%')",
          "as": "sourcePercentLabel"
        }
      ],
      "mark": {
        "type": "arc",
        "radius": 135,
        "radius2": 80,
        "stroke": "white",
        "strokeWidth": 3,
        "cornerRadius": 3
      },
      "encoding": {
        "theta": {
          "field": "sourceTotal",
          "type": "quantitative",
          "stack": true
        },
        "color": {
          "field": "source",
          "type": "nominal",
          "legend": null,
          "scale": {
            "domain": [
              "Oui",
              "Non"
            ],
            "range": [
              "#4C956C",
              "#E23D28"
            ]
          }
        },
        "order": {
          "field": "sourceOrder",
          "type": "quantitative",
          "sort": "ascending"
        },
        "tooltip": [
          {
            "field": "source",
            "type": "nominal",
            "title": "Accès ouvert"
          },
          {
            "field": "sourceTotal",
            "type": "quantitative",
            "title": "Nombre",
            "format": ",d"
          },
          {
            "field": "sourcePercent",
            "type": "quantitative",
            "title": "Part",
            "format": ".1%"
          }
        ]
      }
    },
    {
      "transform": [
        {
          "aggregate": [
            {
              "op": "sum",
              "field": "value",
              "as": "sourceTotal"
            },
            {
              "op": "max",
              "field": "grandTotal",
              "as": "grandTotal"
            },
            {
              "op": "min",
              "field": "sourceOrder",
              "as": "sourceOrder"
            }
          ],
          "groupby": [
            "source"
          ]
        },
        {
          "calculate": "datum.sourceTotal / datum.grandTotal",
          "as": "sourcePercent"
        },
        {
          "calculate": "format(datum.sourcePercent, '.1%')",
          "as": "sourcePercentLabel"
        }
      ],
      "mark": {
        "type": "text",
        "radius": 107,
        "dy": -8,
        "fontSize": 15,
        "fontWeight": "bold",
        "color": "white"
      },
      "encoding": {
        "theta": {
          "field": "sourceTotal",
          "type": "quantitative",
          "stack": true
        },
        "order": {
          "field": "sourceOrder",
          "type": "quantitative",
          "sort": "ascending"
        },
        "text": {
          "field": "source",
          "type": "nominal"
        }
      }
    },
    {
      "transform": [
        {
          "aggregate": [
            {
              "op": "sum",
              "field": "value",
              "as": "sourceTotal"
            },
            {
              "op": "max",
              "field": "grandTotal",
              "as": "grandTotal"
            },
            {
              "op": "min",
              "field": "sourceOrder",
              "as": "sourceOrder"
            }
          ],
          "groupby": [
            "source"
          ]
        },
        {
          "calculate": "datum.sourceTotal / datum.grandTotal",
          "as": "sourcePercent"
        },
        {
          "calculate": "format(datum.sourcePercent, '.1%')",
          "as": "sourcePercentLabel"
        }
      ],
      "mark": {
        "type": "text",
        "radius": 107,
        "dy": 10,
        "fontSize": 13,
        "fontWeight": "bold",
        "color": "white"
      },
      "encoding": {
        "theta": {
          "field": "sourceTotal",
          "type": "quantitative",
          "stack": true
        },
        "order": {
          "field": "sourceOrder",
          "type": "quantitative",
          "sort": "ascending"
        },
        "text": {
          "field": "sourcePercentLabel",
          "type": "nominal"
        }
      }
    },
    {
      "mark": {
        "type": "arc",
        "radius": 200,
        "radius2": 145,
        "stroke": "white",
        "strokeWidth": 3,
        "cornerRadius": 3
      },
      "encoding": {
        "theta": {
          "field": "value",
          "type": "quantitative",
          "stack": true
        },
        "color": {
          "field": "target",
          "type": "nominal",
          "legend": null,
          "scale": {
            "domain": [
              "Diamond",
              "Gold",
              "Green",
              "Bronze",
              "Hybrid",
              "Closed"
            ],
            "range": [
              "#00BFFF",
              "#FFC40C",
              "#4CBB17",
              "#CD7F32",
              "#EC5800",
              "#E23D28"
            ]
          }
        },
        "order": {
          "field": "targetOrder",
          "type": "quantitative",
          "sort": "ascending"
        },
        "tooltip": [
          {
            "field": "source",
            "type": "nominal",
            "title": "Accès ouvert"
          },
          {
            "field": "target",
            "type": "nominal",
            "title": "Voie"
          },
          {
            "field": "value",
            "type": "quantitative",
            "title": "Nombre",
            "format": ",d"
          },
          {
            "field": "targetPercent",
            "type": "quantitative",
            "title": "Part",
            "format": ".1%"
          }
        ]
      }
    },
    {
      "mark": {
        "type": "text",
        "radius": 172,
        "dy": -8,
        "fontSize": 12,
        "fontWeight": "bold",
        "color": "#111"
      },
      "encoding": {
        "theta": {
          "field": "value",
          "type": "quantitative",
          "stack": true
        },
        "order": {
          "field": "targetOrder",
          "type": "quantitative",
          "sort": "ascending"
        },
        "text": {
          "field": "targetVisibleLabel",
          "type": "nominal"
        }
      }
    },
    {
      "mark": {
        "type": "text",
        "radius": 172,
        "dy": 9,
        "fontSize": 12,
        "fontWeight": "bold",
        "color": "#111"
      },
      "encoding": {
        "theta": {
          "field": "value",
          "type": "quantitative",
          "stack": true
        },
        "order": {
          "field": "targetOrder",
          "type": "quantitative",
          "sort": "ascending"
        },
        "text": {
          "field": "targetVisiblePercent",
          "type": "nominal"
        }
      }
    },
    {
      "transform": [
        {
          "aggregate": [
            {
              "op": "sum",
              "field": "value",
              "as": "total"
            }
          ]
        }
      ],
      "mark": {
        "type": "text",
        "fontSize": 26,
        "fontWeight": "bold",
        "color": "#00284B"
      },
      "encoding": {
        "text": {
          "field": "total",
          "type": "quantitative",
          "format": ",d"
        }
      }
    },
    {
      "mark": {
        "type": "text",
        "fontSize": 13,
        "dy": 25,
        "color": "#555"
      },
      "encoding": {
        "text": {
          "datum": "publications"
        }
      }
    }
  ],
  "resolve": {
    "scale": {
      "color": "independent"
    }
  },
  "config": {
    "view": {
      "stroke": null
    }
  }
}
Adapter le graphique à vos données
Pour utiliser cette recette avec d’autres données, certaines parties du script doivent être adaptées.
L’ordre des catégories principales est défini ici :
{
  "calculate": "datum.source === 'Oui' ? 1 : datum.source === 'Non' ? 2 : 99",
  "as": "sourceOrder"
}
Remplacez Oui et Non par les valeurs présentes dans votre champ source.
L’ordre des sous-catégories est défini ici :
{
  "calculate": "datum.target === 'Diamond' ? 1 : datum.target === 'Gold' ? 2 : datum.target === 'Green' ? 3 : datum.target === 'Bronze' ? 4 : datum.target === 'Hybrid' ? 5 : datum.target === 'Closed' ? 6 : 99",
  "as": "targetOrder"
}
Remplacez ces valeurs par celles présentes dans votre champ target.
targetOrder. L’ordre des groupes doit également correspondre à celui défini dans sourceOrder. C’est ce qui permet de conserver l’alignement entre les deux cercles.
Les couleurs du cercle intérieur sont définies dans :
"scale": {
  "domain": [
    "Oui",
    "Non"
  ],
  "range": [
    "#4C956C",
    "#E23D28"
  ]
}
Les couleurs du cercle extérieur sont définies dans :
"scale": {
  "domain": [
    "Diamond",
    "Gold",
    "Green",
    "Bronze",
    "Hybrid",
    "Closed"
  ],
  "range": [
    "#00BFFF",
    "#FFC40C",
    "#4CBB17",
    "#CD7F32",
    "#EC5800",
    "#E23D28"
  ]
}
Chaque valeur du tableau domain correspond à la couleur située à la même position dans le tableau range.
Affichage des pourcentages
Les pourcentages sont calculés automatiquement à partir du champ weight. Ils sont affichés directement dans les cercles ainsi que dans les infobulles.
Pour éviter de surcharger les petites portions, les libellés du cercle extérieur sont masqués lorsqu’ils représentent moins de 4 % du total :
{
  "calculate": "datum.targetPercent >= 0.04 ? datum.target : ''",
  "as": "targetVisibleLabel"
},
{
  "calculate": "datum.targetPercent >= 0.04 ? format(datum.targetPercent, '.1%') : ''",
  "as": "targetVisiblePercent"
}
Vous pouvez modifier ce seuil. Par exemple, utilisez 0.02 pour afficher les catégories représentant au moins 2 % du total ou 0.05 pour un seuil de 5 %.
Modifier le texte central
Le total est calculé automatiquement. Le texte affiché sous celui-ci est défini ici :
"text": {
  "datum": "publications"
}
Remplacez publications par le type de ressources représenté, par exemple documents, projets, ressources ou établissements.
source, target et weight, dès lors que les valeurs de target peuvent être rattachées à des catégories source. Elle peut par exemple être utilisée pour représenter des types de documents et leurs sous-types, des catégories de projets et leurs statuts, des disciplines et leurs sous-disciplines ou toute autre organisation hiérarchique à deux niveaux.
Diagramme à barres empilées
Le diagramme à barres empilées permet de représenter simultanément l’évolution d’un ensemble et sa répartition entre plusieurs catégories.
Dans cet exemple, chaque barre représente le nombre de publications d’une année et les différentes portions qui la composent correspondent aux voies d’accès à la science ouverte : Diamond, Gold, Green, Bronze, Hybrid ou Closed.
Configurer la routine
Dans cet exemple, les données sont préparées à l’aide de la routine pairing-with.
La routine prend en entrée deux champs :
- Champ source : l’année de publication ;
- Champ cible : la voie d’accès à la science ouverte.

Elle produit automatiquement une structure de données contenant trois champs :
{
  "source": "2023",
  "target": "Gold",
  "weight": 42
}
- source : la première dimension, ici l’année de publication ;
- target : la seconde dimension, ici la voie d’accès ;
- weight : le nombre de publications correspondant à cette combinaison.
Cette structure permet à Vega-Lite de construire une barre pour chaque année et de la subdiviser en fonction des différentes valeurs de target.
Créer le graphique
Le script suivant construit le diagramme à barres empilées à partir des champs source, target et weight.
Il calcule également le nombre total de publications pour chaque année ainsi que la part représentée par chaque voie d’accès. Cette dernière est stockée dans le champ Taux et affichée dans l’infobulle sous l’intitulé % Publication.
{
  "background": "transparent",
  "width": "container",
  "height": "container",
  "autosize": {
    "type": "fit",
    "contains": "padding"
  },
  "transform": [
    {
      "window": [
        {
          "op": "sum",
          "field": "weight",
          "as": "NbDocsParAnnnées"
        }
      ],
      "groupby": [
        "source"
      ],
      "frame": [
        null,
        null
      ]
    },
    {
      "calculate": "round(datum.weight*1000/datum.NbDocsParAnnnées)/1000",
      "as": "Taux"
    }
  ],
  "layer": [
    {
      "mark": {
        "type": "bar"
      },
      "encoding": {
        "x": {
          "field": "source",
          "type": "nominal",
          "axis": {
            "labelAngle": 0,
            "labelOverlap": true
          },
          "title": "Années",
          "sort": "x"
        },
        "y": {
          "field": "weight",
          "type": "quantitative",
          "axis": {
            "labelAngle": 0
          },
          "scale": {
            "type": "linear"
          },
          "title": "Nombre de documents"
        },
        "color": {
          "field": "target",
          "title": "Voie d'accès",
          "scale": {
            "domain": [
              "Diamond",
              "Gold",
              "Green",
              "Bronze",
              "Hybrid",
              "Closed"
            ],
            "range": [
              "#00bfff",
              "#f9bc01",
              "#228B22",
              "#c97522",
              "#ffff67",
              "#7f7f7f"
            ]
          }
        },
        "tooltip": [
          {
            "field": "NbDocsParAnnnées",
            "title": "N Docs de l'année",
            "type": "quantitative"
          },
          {
            "field": "target",
            "type": "nominal",
            "title": "Voie d'accès"
          },
          {
            "field": "weight",
            "type": "quantitative",
            "title": "Nb Docs Année / Statut OA"
          },
          {
            "field": "Taux",
            "title": "% Publication",
            "format": ".1%",
            "type": "quantitative"
          }
        ],
        "size": {
          "value": 60
        },
        "mark": {
          "type": "text",
          "color": "darkblue",
          "fontSize": 20,
          "fontWeight": "bold",
          "baseline": "bottom",
          "align": "center",
          "sort": "target",
          "dx": 0,
          "dy": -5
        },
        "encoding": {
          "x": {
            "field": "source",
            "type": "nominal",
            "title": "",
            "sort": "x"
          },
          "y": {
            "line": {
              "field": "target",
              "type": "quantitative"
            }
          }
        }
      }
    },
    {
      "mark": {
        "type": "text",
        "color": "black",
        "fontSize": 20,
        "fontWeight": "bold",
        "baseline": "bottom",
        "align": "center",
        "dx": 0,
        "dy": -5
      },
      "encoding": {
        "x": {
          "field": "source",
          "type": "nominal",
          "title": "",
          "sort": null
        },
        "y": {
          "field": "NbDocsParAnnnées",
          "type": "quantitative",
          "axis": {
            "labelAngle": 0,
            "tickMinStep": 1
          },
          "scale": {
            "type": "linear"
          },
          "sort": null
        },
        "text": {
          "field": "NbDocsParAnnnées",
          "type": "quantitative"
        }
      }
    }
  ],
  "data": {
    "name": "values"
  }
}
Adapter le graphique à vos données
Pour utiliser cette recette avec d’autres données, adaptez les champs utilisés par la routine pairing-with. Le champ source détermine les différentes barres du graphique, tandis que le champ target détermine les catégories empilées à l’intérieur de chaque barre.
Modifier les catégories et les couleurs
Les catégories et les couleurs qui leur sont associées sont définies dans les propriétés domain et range :
"scale": {
  "domain": [
    "Diamond",
    "Gold",
    "Green",
    "Bronze",
    "Hybrid",
    "Closed"
  ],
  "range": [
    "#00bfff",
    "#f9bc01",
    "#228B22",
    "#c97522",
    "#ffff67",
    "#7f7f7f"
  ]
}
Chaque valeur du tableau domain correspond à la couleur située à la même position dans le tableau range. Remplacez ces valeurs par les catégories et les couleurs correspondant à votre propre jeu de données.
Modifier les axes
Le champ utilisé sur l’axe horizontal est défini ici :
"x": {
  "field": "source",
  "type": "nominal",
  "title": "Années"
}
Le titre Années peut être remplacé par l’intitulé correspondant à votre champ source.
L’axe vertical représente les effectifs contenus dans le champ weight :
"y": {
  "field": "weight",
  "type": "quantitative",
  "title": "Nombre de documents"
}
Vous pouvez également adapter le titre Nombre de documents au type de ressources représenté.
Modifier les informations affichées au survol
Les informations présentes dans l’infobulle sont définies dans la propriété tooltip. Dans cet exemple, elle affiche le nombre total de documents de l’année, la voie d’accès, le nombre de documents correspondant à cette voie et sa part dans l’ensemble des publications de l’année.
Les intitulés peuvent être adaptés en modifiant les propriétés title.
Modifier la largeur des barres
La largeur des barres est définie par la propriété size :
"size": {
  "value": 60
}
Augmentez cette valeur pour obtenir des barres plus larges ou diminuez-la pour les rendre plus étroites.
source, target et weight. Elle permet notamment de comparer la composition de plusieurs groupes, périodes ou catégories.
Graphique en courbe
Le graphique en courbe est particulièrement adapté pour représenter une évolution au cours du temps ou comparer plusieurs séries de données sur un même axe. Par exemple, il permet de visualiser le nombre de publications par année selon leur statut Open Access.
Configurer la routine
Dans cet exemple, les données sont préparées à l’aide de la routine pairing-with.
La routine prend en entrée deux champs :
- Champ source : Année de publication.
- Champ cible : Open Access.

Elle produit automatiquement une structure de données contenant trois champs :
{
  "source": "2018",
  "target": "Ouvert",
  "weight": 42
}
- source : les valeurs affichées sur l’axe des abscisses, ici les années de publication.
- target : les différentes séries représentées par une courbe, ici les statuts Open Access.
- weight : le nombre de documents correspondant à chaque couple
source/target.
Cette structure est directement exploitable par Vega-Lite pour tracer une courbe par valeur du champ target.
Créer le graphique
Le script suivant trace une courbe pour chaque valeur du champ target. Les valeurs du champ source sont placées sur l’axe horizontal et les effectifs contenus dans weight sur l’axe vertical.
{
  "background": "transparent",
  "padding": 40,
  "width": "container",
  "height": 400,
  "autosize": {
    "type": "fit",
    "contains": "padding"
  },
  "transform": [
    {
      "filter": "datum.source != null && datum.source != '' && datum.target != null && datum.target != '' && datum.weight > 0"
    }
  ],
  "mark": {
    "type": "line",
    "point": {
      "filled": true,
      "size": 40
    },
    "strokeWidth": 3
  },
  "encoding": {
    "x": {
      "field": "source",
      "type": "ordinal",
      "sort": "ascending",
      "title": "Nom de l'axe des abscisses",
      "axis": {
        "labelAngle": 0,
        "labelOverlap": true
      }
    },
    "y": {
      "aggregate": "sum",
      "field": "weight",
      "type": "quantitative",
      "title": "Nom de l'axe des ordonnées",
      "axis": {
        "format": "d",
        "tickMinStep": 1
      }
    },
    "color": {
      "field": "target",
      "type": "nominal",
      "title": "Légende"
    },
    "tooltip": [
      {
        "field": "source",
        "type": "ordinal",
        "title": "Axe X"
      },
      {
        "field": "target",
        "type": "nominal",
        "title": "Courbe / Ressource"
      },
      {
        "aggregate": "sum",
        "field": "weight",
        "type": "quantitative",
        "title": "Nombre de documents"
      }
    ]
  }
}
Adapter le graphique à vos données
Pour utiliser cette recette avec d’autres données, adaptez tout d’abord les champs utilisés par la routine pairing-with. Le champ source correspond aux valeurs placées sur l’axe horizontal, tandis que chaque valeur du champ target produit une série distincte.
Modifier le titre des axes
Le titre de l’axe horizontal est défini dans :
"x": {
  "field": "source",
  "type": "ordinal",
  "title": "Nom de l'axe des abscisses"
}
Remplacez Nom de l'axe des abscisses par l’intitulé correspondant à votre champ source, par exemple Année de publication.
Le titre de l’axe vertical est défini dans :
"y": {
  "aggregate": "sum",
  "field": "weight",
  "type": "quantitative",
  "title": "Nom de l'axe des ordonnées"
}
Remplacez Nom de l'axe des ordonnées par le type de valeur représenté, par exemple Nombre de publications.
Modifier le titre de la légende
La légende correspond aux différentes valeurs du champ target. Son titre est défini ici :
"color": {
  "field": "target",
  "type": "nominal",
  "title": "Légende"
}
Vous pouvez remplacer Légende par un intitulé adapté à vos données, par exemple Statut Open Access.
Modifier l’apparence des courbes
L’épaisseur des courbes est définie par la propriété strokeWidth :
"strokeWidth": 3
La taille des points affichés sur les courbes est définie ici :
"point": {
  "filled": true,
  "size": 40
}
Vous pouvez augmenter ou diminuer ces valeurs pour adapter l’affichage du graphique.
Modifier les informations affichées au survol
Les informations présentes dans l’infobulle sont définies dans la propriété tooltip. Dans cet exemple, elle affiche la valeur de l’axe horizontal, la série correspondante et le nombre de documents.
Les intitulés peuvent être adaptés en modifiant les propriétés title.
source, target et weight. Vous pouvez par exemple représenter une évolution par type de document, discipline, laboratoire, pays ou toute autre catégorie adaptée à votre jeu de données.
Cette recette est issue d’une proposition d’une utilisatrice de LODEX. Merci à elle pour ce partage.
Graphique en aire
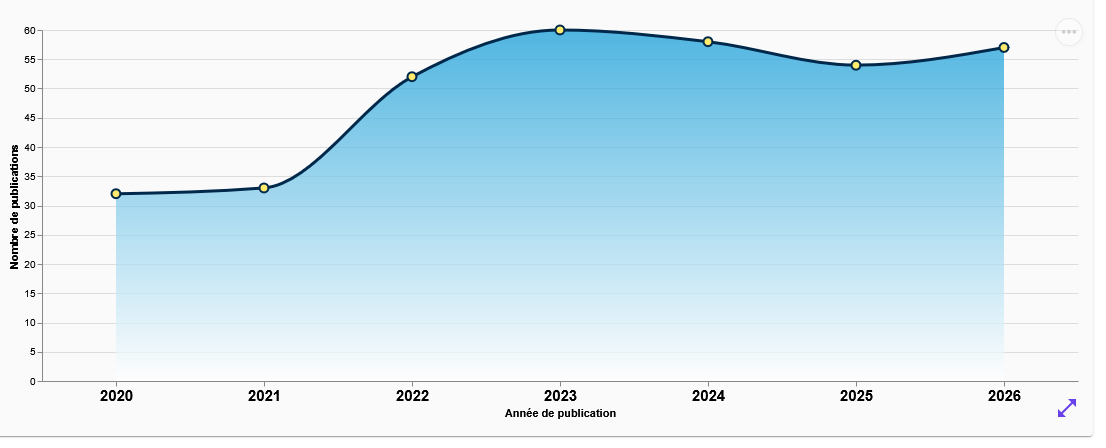
Le graphique en aire permet de représenter l’évolution d’une valeur au fil du temps en combinant une courbe et une zone remplie sous celle-ci.
Dans cet exemple, le graphique représente le nombre de publications par année. L’aire utilise un dégradé vertical allant du blanc au bleu, tandis qu’une ligne et des points permettent de suivre plus facilement l’évolution des valeurs.
L’infobulle fournit également des informations complémentaires : le nombre de publications, la part représentée par chaque année sur l’ensemble de la période et l’évolution par rapport à l’année précédente.
Configurer la routine
Dans cet exemple, les données utilisées par le graphique doivent fournir une valeur pour chaque année. On utilise donc la routine distinct-by.
La structure attendue est de la forme :
{
  "_id": "2024",
  "value": 58
}- _id : la valeur placée sur l’axe horizontal, ici l’année de publication ;
- value : la valeur représentée par l’aire, ici le nombre de publications.
Créer le graphique
Le script suivant construit un graphique en aire à partir des champs _id et value. Il utilise un dégradé de couleur, une courbe et des points pour représenter l’évolution des valeurs. Des transformations permettent également de calculer la part de chaque valeur sur l’ensemble de la période ainsi que son évolution par rapport à la valeur précédente.
{
  "transform": [
    {
      "window": [
        {
          "op": "sum",
          "field": "value",
          "as": "NbPublisPerYear"
        }
      ],
      "frame": [null, null]
    },
    {
      "calculate": "datum.value/datum.NbPublisPerYear",
      "as": "Taux"
    },
    {
      "window": [
        {
          "op": "lag",
          "field": "value",
          "as": "prev_value"
        }
      ],
      "sort": [
        {
          "field": "_id"
        }
      ]
    },
    {
      "calculate": "datum.prev_value == null ? '' : (datum.value - datum.prev_value) / datum.prev_value * 100",
      "as": "percentage_change"
    },
    {
      "calculate": "datum.percentage_change == 0 ? '' : (datum.percentage_change > 0 ? '+' : '') + format(datum.percentage_change, '.1f') + '%'",
      "as": "formatted_percentage_change"
    }
  ],
  "layer": [
    {
      "params": [
        {
          "name": "highlight",
          "select": {
            "type": "point",
            "on": "pointerover"
          }
        },
        {
          "name": "select",
          "select": "point",
          "value": null
        }
      ],
      "mark": {
        "type": "area",
        "interpolate": "monotone",
        "line": {
          "color": "#00284b",
          "strokeWidth": 3
        },
        "color": {
          "x1": 1,
          "y1": 1,
          "x2": 1,
          "y2": 0,
          "gradient": "linear",
          "stops": [
            {
              "offset": 0,
              "color": "white"
            },
            {
              "offset": 1,
              "color": "#0798d6"
            }
          ]
        },
        "point": {
          "filled": true,
          "fill": "#ffeb6e",
          "stroke": "#00284b",
          "strokeWidth": 2,
          "size": 80
        },
        "cursor": "pointer"
      },
      "encoding": {
        "x": {
          "field": "_id",
          "type": "ordinal",
          "axis": {
            "labelAngle": 0,
            "labelOverlap": true,
            "labelFontSize": 15,
            "labelFontStyle": "bold"
          },
          "title": "Année de publication",
          "sort": "ascending"
        },
        "y": {
          "field": "value",
          "type": "quantitative",
          "axis": {
            "labelAngle": 0
          },
          "scale": {
            "type": "linear",
            "zero": true
          },
          "title": "Nombre de publications"
        },
        "tooltip": [
          {
            "field": "_id",
            "type": "ordinal",
            "title": "Année de publication"
          },
          {
            "field": "value",
            "type": "quantitative",
            "title": "Nombre de publications"
          },
          {
            "field": "Taux",
            "title": "Taux de publication par rapport à l'ensemble de la période",
            "format": ".1%",
            "type": "quantitative"
          },
          {
            "field": "formatted_percentage_change",
            "title": "Évolution par rapport à l'année N-1"
          }
        ]
      }
    }
  ],
  "config": {
    "view": {
      "strokeWidth": 0
    }
  },
  "background": "transparent",
  "width": "container",
  "height": "container",
  "autosize": {
    "type": "fit",
    "contains": "padding",
    "resize": true
  }
}
Adapter le graphique à vos données
Pour réutiliser ce modèle avec d’autres données, les principales modifications concernent les titres des axes, les couleurs, l’apparence de la courbe et les informations affichées dans l’infobulle.
Modifier le titre des axes
Le titre de l’axe horizontal peut être adapté ici :
"title": "Année de publication"Celui de l’axe vertical est défini ici :
"title": "Nombre de publications"Modifier les couleurs et le dégradé
La couleur de l’aire est définie à l’aide d’un dégradé :
"color": {
  "x1": 1,
  "y1": 1,
  "x2": 1,
  "y2": 0,
  "gradient": "linear",
  "stops": [
    {
      "offset": 0,
      "color": "white"
    },
    {
      "offset": 1,
      "color": "#0798d6"
    }
  ]
}
Vous pouvez remplacer les couleurs définies dans stops pour adapter le dégradé à votre propre charte graphique.
Modifier l’apparence de la courbe
La ligne qui délimite l’aire est définie ici :
"line": {
  "color": "#00284b",
  "strokeWidth": 3
}
La propriété color permet de modifier sa couleur et strokeWidth son épaisseur.
Modifier les points
L’apparence des points placés sur la courbe est définie dans la propriété point :
"point": {
  "filled": true,
  "fill": "#ffeb6e",
  "stroke": "#00284b",
  "strokeWidth": 2,
  "size": 80
}sizedétermine la taille des points ;fillleur couleur intérieure ;strokela couleur de leur contour ;strokeWidthl’épaisseur du contour.
Modifier la forme de la courbe
Le graphique utilise l’interpolation monotone :
"interpolate": "monotone"Cette interpolation permet d’obtenir des transitions arrondies entre les différents points.
Modifier les informations affichées au survol
Les infobulles peuvent afficher les valeurs présentes dans les données mais également les informations calculées par les transformations Vega-Lite.
Dans cet exemple, elles présentent l’année, le nombre de publications, la part de l’année sur l’ensemble de la période et l’évolution par rapport à l’année précédente.
Graphique en aires superposées
Le graphique en aires superposées permet de représenter l’évolution de plusieurs séries sur un même axe tout en donnant une représentation visuelle de leur importance respective.
Contrairement à un graphique en aires empilées, les différentes séries ne sont pas additionnées les unes aux autres : elles sont dessinées sur le même espace et se superposent. L’utilisation de couleurs, de transparence et de styles de lignes différents permet de les distinguer.
Dans cet exemple, le graphique représente l’évolution du nombre de thèses selon leur statut. Les thèses Soutenue sont représentées par une aire bleue et les thèses En cours par une aire violette superposée.
Configurer la routine
Dans cet exemple, les données sont préparées à l’aide de la routine cross-by.
Deux champs sont croisés :
- Statut de la thèse : par exemple
SoutenueouEn cours. - Année de référence : l’année utilisée pour représenter l’évolution dans le temps.
La routine produit une structure de données contenant trois champs :
{
  "source": "Soutenue",
  "target": "2023",
  "weight": 50
}
- source : la série à représenter, ici le statut de la thèse ;
- target : la valeur placée sur l’axe horizontal, ici l’année de référence ;
- weight : le nombre de ressources correspondant à chaque couple
source/target.
Cette structure permet à Vega-Lite de tracer une aire différente pour chacune des valeurs du champ source.
Créer le graphique
Le script suivant construit deux aires superposées à partir des champs source, target et weight. Chaque série possède son propre style afin de faciliter leur comparaison : couleur, dégradé, ligne, points et transparence.
{
  "$schema": "https://vega.github.io/schema/vega-lite/v6.json",
  "background": "transparent",
  "padding": 35,
  "width": "container",
  "height": "container",
  "autosize": {
    "type": "fit",
    "contains": "padding"
  },
  "transform": [
    {
      "filter": "datum.target != null && datum.target != '' && datum.target != '?'"
    },
    {
      "calculate": "toNumber(datum.target)",
      "as": "year"
    }
  ],
  "encoding": {
    "x": {
      "field": "year",
      "type": "ordinal",
      "title": "Année de référence",
      "sort": "ascending",
      "axis": {
        "labelAngle": 0,
        "labelFontSize": 14,
        "labelFontWeight": "bold",
        "titleFontSize": 16,
        "titleFontWeight": "bold",
        "titlePadding": 15
      }
    },
    "y": {
      "field": "weight",
      "type": "quantitative",
      "title": "Nombre de thèses",
      "axis": {
        "grid": true,
        "labelFontSize": 14,
        "titleFontSize": 16,
        "titleFontWeight": "bold",
        "titlePadding": 15
      }
    },
    "tooltip": [
      {
        "field": "source",
        "type": "nominal",
        "title": "Statut"
      },
      {
        "field": "year",
        "type": "ordinal",
        "title": "Année"
      },
      {
        "field": "weight",
        "type": "quantitative",
        "title": "Nombre de thèses"
      }
    ]
  },
  "layer": [
    {
      "transform": [
        {
          "filter": "datum.source == 'Soutenue'"
        }
      ],
      "mark": {
        "type": "area",
        "interpolate": "monotone",
        "point": {
          "filled": true,
          "size": 75,
          "fill": "#ffeb6e",
          "stroke": "#00284b",
          "strokeWidth": 2
        },
        "line": {
          "color": "#00284b",
          "strokeWidth": 3
        },
        "color": {
          "x1": 1,
          "y1": 1,
          "x2": 1,
          "y2": 0,
          "gradient": "linear",
          "stops": [
            {
              "offset": 0,
              "color": "white"
            },
            {
              "offset": 1,
              "color": "#0798d6"
            }
          ]
        }
      }
    },
    {
      "transform": [
        {
          "filter": "datum.source == 'En cours'"
        }
      ],
      "mark": {
        "type": "area",
        "interpolate": "monotone",
        "point": {
          "filled": true,
          "size": 75,
          "fill": "white",
          "stroke": "#6941eb",
          "strokeWidth": 2
        },
        "line": {
          "color": "#6941eb",
          "strokeWidth": 3,
          "strokeDash": [
            7,
            5
          ]
        },
        "color": {
          "x1": 1,
          "y1": 1,
          "x2": 1,
          "y2": 0,
          "gradient": "linear",
          "stops": [
            {
              "offset": 0,
              "color": "white"
            },
            {
              "offset": 1,
              "color": "#6941eb"
            }
          ]
        },
        "opacity": 0.35
      }
    },
    {
      "mark": {
        "type": "point",
        "opacity": 0
      },
      "encoding": {
        "color": {
          "field": "source",
          "type": "nominal",
          "title": "Statut de la thèse",
          "scale": {
            "domain": [
              "Soutenue",
              "En cours"
            ],
            "range": [
              "#0798d6",
              "#6941eb"
            ]
          },
          "legend": {
            "orient": "top",
            "direction": "horizontal",
            "titleFontSize": 14,
            "titleFontWeight": "bold",
            "labelFontSize": 13,
            "symbolType": "circle",
            "symbolSize": 120
          }
        }
      }
    }
  ]
}
Adapter le graphique à vos données
Pour réutiliser cette recette avec d’autres données, les principales modifications concernent les valeurs du champ source, les axes et l’apparence de chacune des séries.
Choisir les séries à représenter
Chaque aire est créée dans une couche distincte et sélectionnée à l’aide d’un filtre.
La première aire correspond ici aux thèses soutenues :
"transform": [
  {
    "filter": "datum.source == 'Soutenue'"
  }
]
La seconde correspond aux thèses en cours :
"transform": [
  {
    "filter": "datum.source == 'En cours'"
  }
]
Remplacez Soutenue et En cours par les valeurs du champ source que vous souhaitez comparer.
source ne seront donc pas affichées.
Adapter l’axe temporel
Les valeurs du champ target correspondent ici à des années. Le script commence par écarter les valeurs absentes ou non exploitables :
{
  "filter": "datum.target != null && datum.target != '' && datum.target != '?'"
}
Elles sont ensuite converties en nombres dans un nouveau champ year :
{
  "calculate": "toNumber(datum.target)",
  "as": "year"
}
Ce champ est ensuite utilisé sur l’axe horizontal :
"x": {
  "field": "year",
  "type": "ordinal",
  "title": "Année de référence",
  "sort": "ascending"
}
Si votre champ target contient également des années, vous pouvez conserver ce fonctionnement et simplement adapter le titre de l’axe.
Modifier le titre des axes
Le titre de l’axe horizontal est défini ici :
"title": "Année de référence"
Celui de l’axe vertical est défini ici :
"title": "Nombre de thèses"
Remplacez ces intitulés par ceux correspondant à vos données.
Modifier les couleurs et les dégradés
Chaque aire peut utiliser son propre dégradé. Pour la série Soutenue, il est défini ici :
"color": {
  "x1": 1,
  "y1": 1,
  "x2": 1,
  "y2": 0,
  "gradient": "linear",
  "stops": [
    {
      "offset": 0,
      "color": "white"
    },
    {
      "offset": 1,
      "color": "#0798d6"
    }
  ]
}
La seconde série utilise le même principe avec la couleur #6941eb.
Vous pouvez remplacer ces couleurs par celles de votre choix. Les deux valeurs définies dans stops déterminent les extrémités du dégradé.
Modifier l’apparence des lignes
La ligne de la série Soutenue est continue :
"line": {
  "color": "#00284b",
  "strokeWidth": 3
}
Celle de la série En cours est en pointillés :
"line": {
  "color": "#6941eb",
  "strokeWidth": 3,
  "strokeDash": [
    7,
    5
  ]
}
La propriété strokeWidth permet de modifier l’épaisseur de la ligne. La propriété strokeDash permet de créer une ligne discontinue.
Modifier les points
Des points sont affichés sur les valeurs de chaque série. Leur apparence est définie dans la propriété point.
Pour la série Soutenue, par exemple :
"point": {
  "filled": true,
  "size": 75,
  "fill": "#ffeb6e",
  "stroke": "#00284b",
  "strokeWidth": 2
}
sizedétermine la taille du point ;filldétermine sa couleur intérieure ;strokedétermine la couleur de son contour ;strokeWidthdétermine l’épaisseur du contour.
Modifier la transparence
Afin que les différentes aires restent visibles lorsqu’elles se superposent, la série En cours utilise une transparence :
"opacity": 0.35
Une valeur proche de 0 rend l’aire plus transparente, tandis qu’une valeur proche de 1 la rend plus opaque.
Modifier la forme des courbes
Les deux séries utilisent l’interpolation monotone :
"interpolate": "monotone"
Cette interpolation permet d’obtenir des transitions arrondies entre les différents points.
Modifier la légende
La légende est créée à partir du champ source. Les valeurs et les couleurs associées sont définies ici :
"scale": {
  "domain": [
    "Soutenue",
    "En cours"
  ],
  "range": [
    "#0798d6",
    "#6941eb"
  ]
}
Si vous modifiez les séries représentées, adaptez également les valeurs du tableau domain et les couleurs correspondantes dans range.
Le titre de la légende peut être modifié ici :
"title": "Statut de la thèse"
Modifier les informations affichées au survol
Les infobulles affichent actuellement le statut, l’année et le nombre de thèses :
"tooltip": [
  {
    "field": "source",
    "type": "nominal",
    "title": "Statut"
  },
  {
    "field": "year",
    "type": "ordinal",
    "title": "Année"
  },
  {
    "field": "weight",
    "type": "quantitative",
    "title": "Nombre de thèses"
  }
]
Vous pouvez modifier les propriétés title pour adapter les intitulés au contenu de votre graphique.
source, target et weight afin de comparer l’évolution de plusieurs séries sur un même axe. Elle peut par exemple servir à comparer des types de documents, des catégories de projets, des statuts, des établissements ou des disciplines au cours du temps.
Formatage français des dates et des nombres
Vega-Lite permet de convertir l’affichage des dates et des nombres en français en s’appuyant sur une locale adaptée.
En configurant correctement cette locale et en l’utilisant avec les formats appropriés, il est notamment possible d’afficher :
- les mois et les jours en français ;
- des dates lisibles, par exemple
01 janvier 2025; - des nombres conformes aux conventions françaises, par exemple
11 951.
Trois éléments interviennent dans ce formatage : la locale, le type du champ et le format appliqué à son affichage.
Définir une locale française
La première étape consiste à définir une locale. Celle-ci décrit les règles linguistiques et typographiques utilisées lors du formatage, comme les séparateurs numériques ou les noms des mois et des jours.
Dans Vega-Lite, la locale se définit dans la section config.locale de la spécification :
{
  "config": {
    "locale": {
      "number": {
        "decimal": ",",
        "thousands": " ",
        "grouping": [3],
        "currency": ["", " €"],
        "percent": " %"
      },
      "time": {
        "days": [
          "dimanche",
          "lundi",
          "mardi",
          "mercredi",
          "jeudi",
          "vendredi",
          "samedi"
        ],
        "shortDays": [
          "dim.",
          "lun.",
          "mar.",
          "mer.",
          "jeu.",
          "ven.",
          "sam."
        ],
        "months": [
          "janvier",
          "février",
          "mars",
          "avril",
          "mai",
          "juin",
          "juillet",
          "août",
          "septembre",
          "octobre",
          "novembre",
          "décembre"
        ],
        "shortMonths": [
          "janv.",
          "févr.",
          "mars",
          "avr.",
          "mai",
          "juin",
          "juil.",
          "août",
          "sept.",
          "oct.",
          "nov.",
          "déc."
        ]
      }
    }
  }
}
Cette configuration indique à Vega-Lite :
- quel caractère utiliser comme séparateur décimal et comme séparateur de milliers ;
- comment afficher les pourcentages et les monnaies ;
- quels libellés utiliser pour les jours et les mois, en version longue ou abrégée.
format déterminent ensuite où ce formatage doit être appliqué.
Définir correctement le type des données
Pour appliquer le formatage approprié, Vega-Lite doit savoir comment interpréter les données.
Deux types sont particulièrement importants :
temporalpour les dates et les heures ;quantitativepour les valeurs numériques.
Dates : utiliser le type temporal
Un champ contenant une date doit être déclaré avec le type temporal :
{
  "field": "date",
  "type": "temporal"
}
Nombres : utiliser le type quantitative
De la même manière, un champ numérique doit être déclaré avec le type quantitative :
{
  "field": "value",
  "type": "quantitative"
}
La locale définit donc les règles de présentation, tandis que le type indique à Vega-Lite quel moteur de formatage utiliser.
Appliquer un format
Une fois la locale définie et le type du champ correctement renseigné, la propriété format permet de préciser la manière dont la valeur doit être affichée.
Formater une date
Les dates utilisent une syntaxe issue de d3-time-format. Pour afficher une date sous la forme 01 janvier 2025, utilisez par exemple :
{
  "axis": {
    "format": "%d %B %Y"
  }
}
Dans ce format :
%dcorrespond au jour du mois sur deux chiffres ;%Bcorrespond au nom du mois en toutes lettres ;%Ycorrespond à l’année sur quatre chiffres.
Ainsi :
2025-01-01 → 01 janvier 2025
Le nom janvier provient directement de la liste définie dans config.locale.time.months.
Formater un nombre
Le format des nombres utilise la syntaxe de d3-format. Pour afficher un entier avec un séparateur de milliers :
{
  "format": ",d"
}
Dans ce format :
,active le groupement des milliers ;dindique que la valeur doit être affichée comme un entier.
Le caractère utilisé comme séparateur de milliers est ensuite déterminé par la locale française :
1250000 → 1 250 000Exemple : afficher des dates en français

Dans cet exemple, les valeurs du champ _id sont converties en dates, puis affichées avec le nom du mois en français.
{
  "background": "transparent",
  "mark": {
    "type": "bar"
  },
  "transform": [
    {
      "calculate": "toDate(datum._id)",
      "as": "date"
    }
  ],
  "encoding": {
    "x": {
      "field": "date",
      "type": "temporal",
      "title": "",
      "axis": {
        "labelAngle": 0,
        "format": "%d %B %Y"
      }
    },
    "y": {
      "field": "value",
      "type": "quantitative",
      "title": "",
      "axis": {
        "labelAngle": 0,
        "format": ",d"
      },
      "scale": {
        "type": "linear"
      }
    },
    "tooltip": [
      {
        "field": "date",
        "type": "temporal",
        "title": "Date",
        "format": "%d %B %Y"
      },
      {
        "field": "value",
        "type": "quantitative",
        "title": "Nombre",
        "format": ",d"
      }
    ]
  },
  "padding": 18,
  "width": "container",
  "height": "container",
  "autosize": {
    "type": "fit",
    "contains": "padding"
  },
  "config": {
    "view": {
      "strokeWidth": 0
    },
    "locale": {
      "number": {
        "decimal": ",",
        "thousands": " ",
        "grouping": [3],
        "currency": ["", " €"],
        "percent": " %"
      },
      "time": {
        "dateTime": "%A %e %B %Y, %X",
        "date": "%d/%m/%Y",
        "time": "%H:%M:%S",
        "periods": ["AM", "PM"],
        "days": [
          "dimanche",
          "lundi",
          "mardi",
          "mercredi",
          "jeudi",
          "vendredi",
          "samedi"
        ],
        "shortDays": [
          "dim.",
          "lun.",
          "mar.",
          "mer.",
          "jeu.",
          "ven.",
          "sam."
        ],
        "months": [
          "janvier",
          "février",
          "mars",
          "avril",
          "mai",
          "juin",
          "juillet",
          "août",
          "septembre",
          "octobre",
          "novembre",
          "décembre"
        ],
        "shortMonths": [
          "janv.",
          "févr.",
          "mars",
          "avr.",
          "mai",
          "juin",
          "juil.",
          "août",
          "sept.",
          "oct.",
          "nov.",
          "déc."
        ]
      }
    }
  }
}
Trois éléments sont particulièrement importants dans cet exemple :
toDate(datum._id)convertit la valeur d’origine en date exploitable par Vega-Lite ;"type": "temporal"indique qu’il s’agit d’une donnée temporelle ;"format": "%d %B %Y"applique le format souhaité en utilisant les mois définis dans la locale française.
axis et dans tooltip.
Exemple : afficher des nombres au format français

Dans cet exemple, les valeurs numériques sont affichées avec un séparateur de milliers conforme à la locale française.
{
  "params": [
    {
      "name": "highlight",
      "select": {
        "type": "point",
        "on": "pointerover"
      }
    },
    {
      "name": "select",
      "select": "point",
      "value": null
    }
  ],
  "background": "transparent",
  "mark": {
    "type": "bar",
    "cursor": "pointer",
    "stroke": "black"
  },
  "encoding": {
    "x": {
      "field": "value",
      "type": "quantitative",
      "axis": {
        "labelAngle": 0,
        "tickMinStep": 1,
        "format": ",d"
      },
      "scale": {
        "type": "linear"
      },
      "title": "",
      "sort": null
    },
    "y": {
      "field": "_id",
      "type": "nominal",
      "axis": {
        "labelAngle": 0,
        "tickMinStep": 1
      },
      "title": "",
      "sort": null
    },
    "color": {
      "field": "_id",
      "scale": {
        "range": ["#AB8EE2"]
      },
      "type": "nominal",
      "legend": null
    },
    "fillOpacity": {
      "condition": [
        {
          "param": "select",
          "value": 1
        },
        {
          "param": "highlight",
          "empty": false,
          "value": 1
        }
      ],
      "value": 0.3
    },
    "strokeWidth": {
      "condition": [
        {
          "param": "select",
          "empty": false,
          "value": 2
        },
        {
          "param": "highlight",
          "empty": false,
          "value": 1
        }
      ],
      "value": 0
    },
    "tooltip": [
      {
        "field": "_id",
        "type": "nominal",
        "title": "Catégorie"
      },
      {
        "field": "value",
        "type": "quantitative",
        "title": "Valeur",
        "format": ",d"
      }
    ]
  },
  "padding": 18,
  "width": "container",
  "height": {
    "step": "30"
  },
  "autosize": {
    "type": "fit",
    "contains": "padding"
  },
  "config": {
    "locale": {
      "number": {
        "decimal": ",",
        "thousands": " ",
        "grouping": [3],
        "currency": ["", " €"],
        "percent": " %"
      }
    },
    "view": {
      "strokeWidth": 0
    }
  }
}
Ici, le champ value est déclaré en quantitative et le format ,d est appliqué à l’axe :
"axis": {
  "labelAngle": 0,
  "tickMinStep": 1,
  "format": ",d"
}
Le même format est également appliqué dans l’infobulle :
{
  "field": "value",
  "type": "quantitative",
  "title": "Valeur",
  "format": ",d"
}config.locale et les propriétés format dans vos propres visualisations.
Ajouter un sélecteur à un graphique Vega-Lite

Un graphique peut contenir plusieurs catégories de données que l’on souhaite pouvoir afficher séparément, sans avoir à créer plusieurs visualisations.
Vega-Lite permet d’ajouter un sélecteur afin que l’utilisateur choisisse les données qu’il souhaite afficher.
Dans cet exemple, nous partons d’un diagramme en barres et souhaitons proposer trois choix :
positifnégatifni positif ni négatif
Nous partons de ce diagramme en barres classique :
{
  "$schema": "https://vega.github.io/schema/vega-lite/v5.json",
  "background": "transparent",
  "transform": [
    {"filter": "datum._id != 'non concerné'"},
    {"joinaggregate": [{"op": "sum", "field": "value", "as": "total"}]},
    {"calculate": "datum.value / datum.total * 100", "as": "pourcentage"}
  ],
  "layer": [
    {
      "mark": {"type": "bar"},
      "encoding": {
        "x": {
          "field": "value",
          "type": "quantitative",
          "axis": {"labelAngle": 0, "tickMinStep": 1},
          "scale": {"type": "linear"},
          "title": "",
          "sort": null
        },
        "y": {
          "field": "_id",
          "type": "nominal",
          "axis": {"labelAngle": 0, "tickMinStep": 1},
          "title": "",
          "sort": null
        },
        "color": {
          "field": "_id",
          "scale": {
            "range": ["#d7191c", "#fdae61", "#ffffbf", "#abdda4", "#2b83ba"]
          },
          "type": "nominal",
          "legend": null
        },
        "tooltip": [
          {"field": "_id", "type": "nominal", "title": "Catégorie"},
          {"field": "value", "type": "quantitative", "title": "Valeur"},
          {"field": "total", "type": "quantitative", "title": "Sur"},
          {
            "field": "pourcentage",
            "type": "quantitative",
            "format": ".0f",
            "title": "Pourcentage (%)"
          }
        ]
      }
    },
    {
      "mark": {
        "type": "text",
        "color": "black",
        "fontSize": 10,
        "fontWeight": "bold",
        "baseline": "middle",
        "align": "left",
        "dx": 4,
        "dy": 0
      },
      "encoding": {
        "x": {
          "field": "value",
          "type": "quantitative",
          "axis": null,
          "sort": null
        },
        "y": {"field": "_id", "type": "nominal", "title": "", "sort": null},
        "text": {"field": "value", "type": "quantitative"}
      }
    }
  ],
  "padding": 18,
  "config": {"view": {"strokeWidth": 0}},
  "width": "container",
  "height": {"step": 20},
  "autosize": {"type": "fit", "contains": "padding"},
  "data": {
    "values": [
      {
        "_id": "programme positif",
        "value": 28
      },
      {
        "_id": "international positif",
        "value": 18
      },
      {
        "_id": "financement positif",
        "value": 12
      },
      {
        "_id": "reconnaissance positif",
        "value": 8
      },

      {
        "_id": "programme négatif",
        "value": 15
      },
      {
        "_id": "international négatif",
        "value": 10
      },
      {
        "_id": "financement négatif",
        "value": 21
      },
      {
        "_id": "reconnaissance négatif",
        "value": 14
      },

      {
        "_id": "programme ni positif ni négatif",
        "value": 40
      },
      {
        "_id": "international ni positif ni négatif",
        "value": 32
      },
      {
        "_id": "financement ni positif ni négatif",
        "value": 25
      },
      {
        "_id": "reconnaissance ni positif ni négatif",
        "value": 16
      }
    ]
  }
}
ℹ️Le principe présenté ici n’est toutefois pas spécifique aux diagrammes en barres. Le sélecteur agit sur les données avant leur représentation et peut donc être utilisé avec d’autres types de graphiques Vega-Lite.
Préparer les données utilisées par le graphique
Pour pouvoir utiliser le sélecteur, chaque valeur doit contenir à la fois :
- le libellé qui sera utilisé dans le graphique
- la catégorie qui permettra de filtrer les données.
Une solution consiste à regrouper ces deux informations dans une même chaîne en utilisant un séparateur.
Dans notre exemple, nous utilisons :
programme : positif
programme : négatif
international : positif
international : négatif
financement : ni positif ni négatif
La structure est donc toujours la même :
libellé : catégorie
La partie située avant : correspond au libellé qui sera utilisé par le graphique.
La partie située après : correspond à la catégorie utilisée par le sélecteur.
Préparer ses données
Selon la structure du corpus d’origine, il peut être nécessaire de transformer les données avant de créer le graphique.
Par exemple, une valeur telle queFinancement Négatifpeut être transformée en
Financement : négatif.Cette préparation permet ensuite à Vega-Lite de distinguer facilement le libellé de la catégorie utilisée par le sélecteur.
Un exemple de script Lodash permettant de réaliser cette transformation est disponible ici :
Structurer une chaîne de caractères pour distinguer un libellé et une catégorie
Après application de l’enrichissement, puis de la routine, les données transmises au graphique ont cette forme :
[
  {
    "_id": "programme : positif",
    "value": 28
  },
  {
    "_id": "international : positif",
    "value": 18
  },
  {
    "_id": "programme : négatif",
    "value": 15
  },
  {
    "_id": "international : négatif",
    "value": 10
  }
]
La propriété _id contient les deux informations nécessaires tandis que value contient le nombre d’occurrences calculé par la routine.
Ajouter le sélecteur
Le sélecteur est déclaré dans la propriété params de la spécification Vega-Lite.
"params": [
  {
    "name": "selectcategorie",
    "value": "positif",
    "bind": {
      "input": "select",
      "options": [
        "positif",
        "négatif",
        "ni positif ni négatif"
      ],
      "name": "Afficher : "
    }
  }
]
Ce bloc crée une liste déroulante permettant de sélectionner la catégorie à afficher.
Nommer le sélecteur
"name": "selectcategorie"
La propriété name définit le nom interne du paramètre.
Ce nom sera ensuite utilisé dans le filtre afin de récupérer la valeur actuellement choisie par l’utilisateur.
Définir la valeur sélectionnée par défaut
"value": "positif"
La propriété value définit la valeur sélectionnée lors du premier affichage du graphique.
Dans cet exemple, le graphique affiche donc initialement les données appartenant à la catégorie positif.
Créer une liste déroulante
"bind": {
  "input": "select"
}
La propriété bind permet d’associer le paramètre à un élément d’interface.
Avec "input": "select", Vega-Lite crée une liste déroulante.
Définir les valeurs proposées
"options": [
  "positif",
  "négatif",
  "ni positif ni négatif"
]
La propriété options contient les différentes valeurs proposées dans le sélecteur.
Ces valeurs doivent correspondre exactement aux catégories présentes dans les données.
À modifier
Adaptez la propriétéoptionsaux catégories présentes dans votre propre corpus.
Par exemple :
"options": [
  "article",
  "ouvrage",
  "chapitre"
]
ou :
"options": [
  "2024",
  "2025",
  "2026"
]
Séparer le libellé et la catégorie dans Vega-Lite
Les données reçues par Vega-Lite contiennent actuellement une chaîne unique :
international : positifNous devons récupérer séparément :
libelle    → international
categorie  → positif
Pour cela, deux transformations sont ajoutées :
{
  "calculate": "split(datum._id, ' : ')[0]",
  "as": "libelle"
},
{
  "calculate": "split(datum._id, ' : ')[1]",
  "as": "categorie"
}
La fonction split découpe la chaîne en utilisant : comme séparateur.
Ainsi :
international : positifest découpé conceptuellement de cette manière :
["international", "positif"]
Le premier élément est récupéré avec [0] et enregistré dans un nouveau champ appelé libelle.
Le second élément est récupéré avec [1] et enregistré dans un nouveau champ appelé categorie.
international : positif
       │             │
       ▼             ▼
    libelle       categorie
       │             │
       ▼             ▼
international      positif
À modifier
Si vous utilisez un autre séparateur dans vos données, remplacez' : 'dans les deux expressionssplit.
Relier le sélecteur aux données
Nous disposons maintenant :
- d’un champ
categoriedans les données ; - d’un paramètre
selectcategoriecontenant le choix effectué par l’utilisateur.
Il suffit alors de comparer les deux valeurs avec un filtre :
{
  "filter": "datum.categorie == selectcategorie"
}
Pour chaque donnée, Vega-Lite compare donc :
datum.categorieavec :
selectcategorie
Si l’utilisateur choisit négatif, seules les données dont la catégorie vaut négatif sont conservées.
programme : positif       ✕
international : positif   ✕

programme : négatif       ✓
international : négatif   ✓
financement : négatif     ✓
Le graphique est automatiquement mis à jour lorsque l’utilisateur modifie la valeur du sélecteur.
Utiliser le nouveau libellé dans le graphique
Dans le graphique initial, la propriété _id pouvait être utilisée directement comme libellé.
Mais _id contient désormais :
programme : positifNous souhaitons uniquement afficher :
programme
Il faut donc utiliser le nouveau champ libelle dans l’encodage du graphique :
"y": {
  "field": "libelle",
  "type": "nominal",
  "axis": {
    "labelAngle": 0,
    "tickMinStep": 1
  },
  "title": "",
  "sort": null
}
Le même principe peut être appliqué partout où le libellé doit être utilisé, par exemple pour la couleur :
"color": {
  "field": "libelle",
  "scale": {
    "range": [
      "#d7191c",
      "#fdae61",
      "#ffffbf",
      "#abdda4",
      "#2b83ba"
    ]
  },
  "type": "nominal",
  "legend": null
}
Adapter l’infobulle
Les deux informations peuvent également être affichées séparément dans l’infobulle.
"tooltip": [
  {
    "field": "libelle",
    "type": "nominal",
    "title": "Libellé"
  },
  {
    "field": "categorie",
    "type": "nominal",
    "title": "Catégorie"
  },
  {
    "field": "value",
    "type": "quantitative",
    "title": "Valeur"
  },
  {
    "field": "total",
    "type": "quantitative",
    "title": "Sur"
  },
  {
    "field": "pourcentage",
    "type": "quantitative",
    "format": ".0f",
    "title": "Pourcentage (%)"
  }
]
Pour une donnée telle que :
financement : négatifl’infobulle peut ainsi présenter séparément le libellé, la catégorie et la valeur.
Calculer le total après le filtrage
Dans notre exemple, le graphique calcule également un total et un pourcentage.
Le bloc complet des transformations est :
"transform": [
  {
    "calculate": "split(datum._id, ' : ')[0]",
    "as": "libelle"
  },
  {
    "calculate": "split(datum._id, ' : ')[1]",
    "as": "categorie"
  },
  {
    "filter": "datum.categorie == selectcategorie"
  },
  {
    "joinaggregate": [
      {
        "op": "sum",
        "field": "value",
        "as": "total"
      }
    ]
  },
  {
    "calculate": "datum.value / datum.total * 100",
    "as": "pourcentage"
  }
]
L’ordre des transformations est important.
Séparation du libellé et de la catégorie
                    ↓
          choix dans le sélecteur
                    ↓
              filtrage
                    ↓
      calcul du total sélectionné
                    ↓
        calcul des pourcentages
                    ↓
         affichage du graphique
Le filtre est appliqué avant le calcul du total.
Si l’utilisateur sélectionne positif, le total est donc calculé uniquement à partir des valeurs positives.
S’il sélectionne négatif, le total est recalculé à partir des valeurs négatives.
Le code complet du graphique avec sélecteur
{
  "$schema": "https://vega.github.io/schema/vega-lite/v5.json",
  "background": "transparent",

  "params": [
    {
      "name": "selectcategorie",
      "value": "positif",
      "bind": {
        "input": "select",
        "options": [
          "positif",
          "négatif",
          "ni positif ni négatif"
        ],
        "name": "Afficher : "
      }
    }
  ],

  "transform": [
    {
      "calculate": "split(datum._id, ' : ')[0]",
      "as": "libelle"
    },
    {
      "calculate": "split(datum._id, ' : ')[1]",
      "as": "categorie"
    },
    {
      "filter": "datum.categorie == selectcategorie"
    },
    {
      "joinaggregate": [
        {
          "op": "sum",
          "field": "value",
          "as": "total"
        }
      ]
    },
    {
      "calculate": "datum.value / datum.total * 100",
      "as": "pourcentage"
    }
  ],

  "layer": [
    {
      "mark": {
        "type": "bar"
      },
      "encoding": {
        "x": {
          "field": "value",
          "type": "quantitative",
          "axis": {
            "labelAngle": 0,
            "tickMinStep": 1
          },
          "scale": {
            "type": "linear"
          },
          "title": "",
          "sort": null
        },
        "y": {
          "field": "libelle",
          "type": "nominal",
          "axis": {
            "labelAngle": 0,
            "tickMinStep": 1
          },
          "title": "",
          "sort": null
        },
        "color": {
          "field": "libelle",
          "scale": {
            "range": [
              "#d7191c",
              "#fdae61",
              "#ffffbf",
              "#abdda4",
              "#2b83ba"
            ]
          },
          "type": "nominal",
          "legend": null
        },
        "tooltip": [
          {
            "field": "libelle",
            "type": "nominal",
            "title": "Catégorie"
          },
          {
            "field": "categorie",
            "type": "nominal",
            "title": "Catégorie"
          },
          {
            "field": "value",
            "type": "quantitative",
            "title": "Valeur"
          },
          {
            "field": "total",
            "type": "quantitative",
            "title": "Sur"
          },
          {
            "field": "pourcentage",
            "type": "quantitative",
            "format": ".0f",
            "title": "Pourcentage (%)"
          }
        ]
      }
    },

    {
      "mark": {
        "type": "text",
        "color": "black",
        "fontSize": 10,
        "fontWeight": "bold",
        "baseline": "middle",
        "align": "left",
        "dx": 4,
        "dy": 0
      },
      "encoding": {
        "x": {
          "field": "value",
          "type": "quantitative",
          "axis": null,
          "sort": null
        },
        "y": {
          "field": "libelle",
          "type": "nominal",
          "title": "",
          "sort": null
        },
        "text": {
          "field": "value",
          "type": "quantitative"
        }
      }
    }
  ],

  "padding": 18,

  "config": {
    "view": {
      "strokeWidth": 0
    }
  },

  "width": "container",

  "height": {
    "step": 20
  },

  "autosize": {
    "type": "fit",
    "contains": "padding"
  },

  "data": {
    "values": [
      {
        "_id": "programme : positif",
        "value": 28
      },
      {
        "_id": "international : positif",
        "value": 18
      },
      {
        "_id": "financement : positif",
        "value": 12
      },
      {
        "_id": "reconnaissance : positif",
        "value": 8
      },

      {
        "_id": "programme : négatif",
        "value": 15
      },
      {
        "_id": "international : négatif",
        "value": 10
      },
      {
        "_id": "financement : négatif",
        "value": 21
      },
      {
        "_id": "reconnaissance : négatif",
        "value": 14
      },

      {
        "_id": "programme : ni positif ni négatif",
        "value": 40
      },
      {
        "_id": "international : ni positif ni négatif",
        "value": 32
      },
      {
        "_id": "financement : ni positif ni négatif",
        "value": 25
      },
      {
        "_id": "reconnaissance : ni positif ni négatif",
        "value": 16
      }
    ]
  }
}
Utiliser un sélecteur avec d’autres types de graphiques
Dans cet exemple, le sélecteur est utilisé avec un diagramme en barres, mais son fonctionnement n’est pas lié à ce type de représentation.
Le sélecteur intervient dans les transformations Vega-Lite :
{
  "filter": "datum.categorie == selectcategorie"
}
Le filtrage est donc effectué sur les données avant leur représentation graphique.
Données
   ↓
Sélection d'une catégorie
   ↓
Filtrage des données
   ↓
Transformations éventuelles
   ↓
Représentation graphique
Le même mécanisme peut ainsi être utilisé avec différents types de visualisations Vega-Lite : courbes, graphiques en aires, nuages de points, donuts ou encore graphiques combinés.
Par exemple, des données structurées ainsi :
2024 : France
2025 : France
2026 : France

2024 : Allemagne
2025 : Allemagne
2026 : Allemagne
pourraient utiliser la première partie comme information représentée sur l’axe temporel et la seconde comme catégorie permettant de sélectionner le pays.
Le principe reste le même :
split(...)[0] → information utilisée par le graphique
split(...)[1] → information utilisée par le sélecteur
Seuls les champs utilisés dans les propriétés encoding doivent ensuite être adaptés au type de représentation choisi.
À retenir
Le sélecteur est indépendant du type de graphique. Il filtre les données transmises à la visualisation. Une fois le filtre appliqué, Vega-Lite construit le graphique avec les seules données correspondant au choix effectué par l’utilisateur.
Les trois modifications essentielles
Pour ajouter un sélecteur à un graphique existant, trois modifications principales sont nécessaires.
1. Ajouter le sélecteur
"params": [
  {
    "name": "selectcategorie",
    "value": "positif",
    "bind": {
      "input": "select",
      "options": [
        "positif",
        "négatif",
        "ni positif ni négatif"
      ],
      "name": "Afficher : "
    }
  }
]
2. Créer les champs et appliquer le filtre
{
  "calculate": "split(datum._id, ' : ')[0]",
  "as": "libelle"
},
{
  "calculate": "split(datum._id, ' : ')[1]",
  "as": "categorie"
},
{
  "filter": "datum.categorie == selectcategorie"
}
3. Utiliser le nouveau champ pour l’affichage
Dans les différentes parties du graphique qui doivent afficher le libellé, utilisez :
"field": "libelle"à la place de :
"field": "_id"Principe général
Cette méthode ne se limite pas aux catégories positif et négatif.
Elle repose simplement sur des données structurées selon le modèle :
libellé : catégoriePar exemple :
Article scientifique : français
Article scientifique : anglais

Université de Lorraine : 2025
Université de Lorraine : 2026

Publication : ouverte
Publication : fermée
Dans tous les cas, Vega-Lite peut récupérer séparément les deux informations :
split(...)[0] → information utilisée dans le graphique
split(...)[1] → information utilisée par le sélecteur
À retenir
Lorsque plusieurs informations sont regroupées dans une chaîne structurée, par exemplelibellé : catégorie, la fonctionsplitpermet de les séparer directement dans Vega-Lite. L’une peut alors servir à construire la visualisation et l’autre à filtrer les données grâce à un sélecteur.
Identifier les années marquantes d’un domaine scientifique avec la RPYS

Comment repérer les périodes historiques qui ont particulièrement influencé un ensemble de publications scientifiques ? La Reference Publication Year Spectroscopy (RPYS), ou spectroscopie des années de publication des références citées, consiste à examiner les années de publication des travaux cités dans un corpus. Cette méthode fait apparaître les années particulièrement représentées dans les bibliographies.
Dans ce cas d’usage, nous utilisons OpenAlex pour récupérer les références citées, des enrichissements avancés pour les préparer et les compter, puis Vega-Lite pour afficher les résultats. Aucune connaissance préalable de la RPYS n’est nécessaire.
Comprendre le principe de la RPYS
Un corpus est un ensemble de publications sélectionnées pour étudier un sujet. Chaque publication peut citer d’autres travaux dans sa bibliographie. La RPYS ne compte pas les années de publication des documents du corpus : elle compte les années de publication des références que ces documents citent.
Publication A (2020) → cite une référence de 1986 et une de 2004
Publication B (2021) → cite une référence de 1986
Publication C (2019) → cite une référence de 2004 et une de 2004

Résultat :
1986 → 2 citations de références
2004 → 3 citations de références
Une même publication citée par plusieurs documents du corpus est comptée plusieurs fois : nous mesurons ici la fréquence des citations bibliographiques dans le corpus, et non le nombre de références distinctes publiées chaque année.
Pour distinguer les années véritablement remarquables des fluctuations habituelles, nous calculons également une médiane glissante sur cinq ans, puis l’écart entre le nombre de citations observé et cette médiane.
Année étudiée : 2004
Citations observées : 326
Médiane des années 2002 à 2006 : 262
Écart à la médiane : 326 − 262 = +64
Un écart positif élevé signale une année plus citée que son voisinage chronologique. Il constitue une piste d’exploration bibliographique, mais ne suffit pas à identifier automatiquement un texte fondateur.
À retenir
Le graphique comporte deux courbes : la courbe noire représente le nombre de références citées par année ; la courbe rouge représente l’écart à la médiane glissante sur cinq ans. Les dix plus grands écarts positifs sont repérés par un point et une année.
Préparer le corpus OpenAlex
Le point de départ est une instance Lodex contenant des publications récupérées depuis OpenAlex. Chaque document doit disposer d’un champ referenced_works, qui contient les identifiants OpenAlex des travaux présents dans sa bibliographie.
{
  "id": "https://openalex.org/W100000001",
  "title": "Exemple de publication du corpus",
  "publication_year": 2020,
  "referenced_works": [
    "https://openalex.org/W200000001",
    "https://openalex.org/W200000002",
    "https://openalex.org/W200000003"
  ]
}
Cet exemple est fictif : il illustre uniquement la structure attendue. Le champ referenced_works contient des identifiants, pas directement les années des références. Nous devons donc interroger OpenAlex pour récupérer les métadonnées associées à chaque identifiant.
À vérifier dans votre instance
Les expressions EZS ci-dessous supposent que le champreferenced_worksest accessible parvalue.referenced_worksdans l’entrée de l’enrichissement. Si votre champ ou votre structure de données diffère, adaptez ce chemin. Les références absentes d’OpenAlex ou non récupérées par l’API ne pourront pas être comptées.
Enrichissement 1 — Récupérer les métadonnées des références citées
Nous allons envoyer les identifiants à l’API OpenAlex par groupes de 50. Ce regroupement évite de faire une requête HTTP distincte pour chaque référence et permet de limiter la longueur des URL. Afin d’éviter des blocages, il est utile de renseigner sa clé API. Nous nommerons cet enrichissement citedReferencesMetadata.
[assign]
path = value
value = get("value.referenced_works").chunk(50)

[map]
path = value

[map/replace]
path = url
value = self().map(id => id.split('/').pop()).join('|').thru(ids => 'https://api.openalex.org/works?filter=openalex_id:' + ids + '&per-page=50&select=id,title,publication_year,authorships,doi,cited_by_count&api_key=VOTRE_CLE_API_OPENALEX')

[map/URLFetch]
url = get("url")
target = response
json = true
timeout = 15000
noerror = true
retries = 1

[map/exchange]
value = get("response.results")

[assign]
path = value
value = get("value").flatten().map(ref => ({ id: ref.id, title: ref.title, year: ref.publication_year, authors: (ref.authorships || []).map(a => a.author.display_name), doi: ref.doi, cited_by_count: ref.cited_by_count }))
Comprendre les instructions
[assign]etchunk(50)découpent la liste des identifiants en tableaux de 50 éléments.[map]exécute les traitements suivants pour chacun de ces groupes.[map/replace]extrait les identifiants courts (par exempleW200000001), les relie avec|et construit une URL d’interrogation OpenAlex.[map/URLFetch]interroge l’API et place la réponse dansresponse.[map/exchange]ne conserve que le tableauresultsrenvoyé par OpenAlex.- Le dernier
[assign]réunit les résultats avecflatten(), puis les simplifie avecmap().
Remplacez VOTRE_CLE_API_OPENALEX par votre propre clé API. Le paramètre select limite les métadonnées téléchargées aux informations utiles : identifiant, titre, année de publication, auteurs, DOI et nombre global de citations dans OpenAlex. Le champ cited_by_count n’est pas utilisé pour calculer la RPYS : celle-ci repose sur les citations présentes dans notre propre corpus.
Attention aux réponses de l’API
Avecnoerror = true, un échec peut ne pas interrompre tout le traitement. Vérifiez donc que les références ont effectivement été récupérées. Une réponse incomplète ou un dépassement des limites de l’API peut sous-estimer les fréquences de citation. La limite de 50 éléments par requête est un choix pratique pour cet exemple, pas une garantie contre toutes les erreurs.
Le dernier [assign] simplifie directement les réponses OpenAlex : il conserve les identifiants, les titres, les années, les auteurs, les DOI et les nombres globaux de citations. L’expression (ref.authorships || []) permet de gérer les références sans liste d’auteurs.
Le champ citedReferencesMetadata contient alors, pour chaque publication du corpus, un tableau de références semblable à celui-ci :
[
  {
    "id": "https://openalex.org/W200000001",
    "title": "Exemple de référence citée",
    "year": 1986,
    "authors": ["Auteur A", "Auteur B"],
    "doi": null,
    "cited_by_count": 120
  },
  {
    "id": "https://openalex.org/W200000002",
    "title": "Autre référence citée",
    "year": 2004,
    "authors": ["Auteur C"],
    "doi": null,
    "cited_by_count": 85
  }
]
Ces données sont fictives. cited_by_count représente les citations comptabilisées dans OpenAlex, et non les citations dans notre corpus.
Enrichissement 2 — Extraire les années de publication
Pour le premier graphique, nous n’avons plus besoin des titres ou des auteurs. Il suffit de conserver les années des références dans un nouveau champ, nommé citedReferenceYears.
[assign]
path = value
value = get("value.citedReferencesMetadata").map(ref => ref.year).filter(year => year != null)
La fonction get("value.citedReferencesMetadata") lit le champ créé par le premier enrichissement. La fonction map(ref => ref.year) extrait l’année de chaque référence. La fonction filter(year => year != null) retire les références pour lesquelles aucune année n’est renseignée. Les répétitions sont volontairement conservées, car chaque occurrence correspond à une citation bibliographique.
[1986, 2004, 1986, 1974, 2004, 2004]À retenir
Il ne faut pas appliqueruniq()à ce tableau : supprimer les répétitions reviendrait à perdre les fréquences de citation que nous cherchons précisément à mesurer.
Créer la routine
Une fois le champ citedReferenceYears créé et alimenté pour les documents du corpus, utilisez la routine distinct-by portant sur ce champ. La routine rassemble les occurrences d’une même année et compte leur fréquence sur l’ensemble du corpus.
Les données transmises au graphique auront la structure suivante :
[
  {"_id": "1974", "value": 12},
  {"_id": "1986", "value": 28},
  {"_id": "2004", "value": 46}
]
Cet exemple de résultat est fictif. La propriété _id correspond à l’année de publication de la référence citée ; value correspond au nombre d’occurrences de cette année dans les bibliographies du corpus. Il ne s’agit pas du nombre de documents publiés cette année-là.
Calculer les indicateurs RPYS dans Vega-Lite
Le graphique reçoit les résultats de la routine. Les transformations Vega-Lite convertissent les champs, complètent les années absentes, calculent la médiane glissante et déterminent les écarts à cette médiane.
Convertir les années et les fréquences
{"calculate": "toNumber(datum._id)", "as": "year"},
{"calculate": "toNumber(datum.value)", "as": "citations"}
La fonction toNumber() transforme les valeurs reçues en nombres afin de permettre les calculs et de placer correctement les années sur l’axe horizontal.
Compléter les années absentes
{
  "impute": "citations",
  "key": "year",
  "keyvals": {"start": 1818, "stop": 2022, "step": 1},
  "value": 0
}
L’instruction impute ajoute les années absentes entre 1818 et 2021, avec zéro citation. La borne stop est exclue. Cette étape est importante : la médiane doit porter sur des années consécutives, et non uniquement sur celles pour lesquelles la routine a trouvé des références.
Nous utilisons ici la période 1818–2021 pour les calculs et 1879–2021 pour l’affichage du graphique. Ces bornes correspondent à notre exemple historique ; elles sont à adapter pour un autre corpus. Il faut également adapter la borne de filtrage pour éviter d’intégrer des références postérieures à la période étudiée.
Calculer la médiane glissante
{
  "window": [{"op": "median", "field": "citations", "as": "median5"}],
  "sort": [{"field": "year", "order": "ascending"}],
  "frame": [-2, 2]
}
Pour chaque année, frame: [-2, 2] considère les deux années précédentes, l’année courante et les deux années suivantes. La médiane de ces cinq valeurs est enregistrée dans median5. Aux limites de la période disponible, la fenêtre peut contenir moins de cinq années.
Calculer l’écart à la médiane
{"calculate": "datum.citations - datum.median5", "as": "deviation"}La propriété deviation mesure la différence entre la fréquence observée et la médiane locale. Une valeur positive signale une année davantage citée que la valeur médiane de son voisinage.
Repérer les dix plus grands écarts positifs
{"filter": "datum.deviation > 0 && datum.year >= 1879 && datum.year <= 2021"},
{"window": [{"op": "rank", "as": "peakRank"}], "sort": [{"field": "deviation", "order": "descending"}]},
{"filter": "datum.peakRank <= 10"}
Le filtre ne conserve que les écarts positifs situés dans la période affichée. La fonction rank les classe par ordre décroissant, puis le dernier filtre sélectionne les dix premiers rangs. En cas d’égalité, plusieurs années peuvent partager un rang : le graphique peut donc afficher plus de dix points.
Important
Les années sélectionnées sont les années présentant les dix premiers rangs d’écart positif. Ce ne sont pas nécessairement dix maxima locaux distincts. Le repérage statistique aide à orienter l’enquête bibliographique, mais l’identification des publications historiques nécessite une analyse complémentaire.
Créer le graphique Vega-Lite
Créez un graphique de type « Graphique – Syntaxe Vega-Lite » en utilisant les résultats de la routine distinct-by sur citedReferenceYears. Le graphique affiche une courbe noire pour les citations annuelles, une courbe rouge pour les écarts à la médiane, ainsi que des points et des étiquettes sur les années les plus remarquables.
Les infobulles sont adaptées à chaque couche : la courbe noire indique l’année et le nombre de citations ; la courbe rouge ajoute la médiane et l’écart ; les points rouges ajoutent le rang du pic.
Code complet du graphique Vega-Lite
{
  "$schema": "https://vega.github.io/schema/vega-lite/v5.json",
  "width": "container",
  "height": 400,
  "background": "transparent",
  "data": {
    "values": []
  },
  "transform": [
    {
      "calculate": "toNumber(datum._id)",
      "as": "year"
    },
    {
      "calculate": "toNumber(datum.value)",
      "as": "citations"
    },
    {
      "filter": "isValid(datum.year) && datum.year >= 1818 && datum.year <= 2021 && isValid(datum.citations)"
    },
    {
      "impute": "citations",
      "key": "year",
      "keyvals": {
        "start": 1818,
        "stop": 2022,
        "step": 1
      },
      "value": 0
    },
    {
      "window": [
        {
          "op": "median",
          "field": "citations",
          "as": "median5"
        }
      ],
      "sort": [
        {
          "field": "year",
          "order": "ascending"
        }
      ],
      "frame": [
        -2,
        2
      ]
    },
    {
      "calculate": "datum.citations - datum.median5",
      "as": "deviation"
    }
  ],
  "layer": [
    {
      "mark": {
        "type": "line",
        "color": "#333333",
        "strokeWidth": 2,
        "clip": true
      },
      "encoding": {
        "x": {
          "field": "year",
          "type": "quantitative",
          "title": "Année de publication des références",
          "scale": {
            "domain": [
              1879,
              2021
            ],
            "nice": false,
            "zero": false
          },
          "axis": {
            "format": "d",
            "tickMinStep": 1
          }
        },
        "y": {
          "field": "citations",
          "type": "quantitative",
          "title": "Nombre de références citées"
        },
        "tooltip": [
          {
            "field": "year",
            "type": "quantitative",
            "title": "Année de publication",
            "format": "d"
          },
          {
            "field": "citations",
            "type": "quantitative",
            "title": "Nombre de références citées",
            "format": ".0f"
          }
        ]
      }
    },
    {
      "mark": {
        "type": "line",
        "color": "#E85D4A",
        "strokeWidth": 2,
        "clip": true
      },
      "encoding": {
        "x": {
          "field": "year",
          "type": "quantitative"
        },
        "y": {
          "field": "deviation",
          "type": "quantitative"
        },
        "tooltip": [
          {
            "field": "year",
            "type": "quantitative",
            "title": "Année de publication",
            "format": "d"
          },
          {
            "field": "citations",
            "type": "quantitative",
            "title": "Nombre de références citées",
            "format": ".0f"
          },
          {
            "field": "median5",
            "type": "quantitative",
            "title": "Médiane sur cinq ans",
            "format": ".0f"
          },
          {
            "field": "deviation",
            "type": "quantitative",
            "title": "Écart à la médiane",
            "format": "+.0f"
          }
        ]
      }
    },
    {
      "transform": [
        {
          "filter": "datum.deviation > 0 && datum.year >= 1879 && datum.year <= 2021"
        },
        {
          "window": [
            {
              "op": "rank",
              "as": "peakRank"
            }
          ],
          "sort": [
            {
              "field": "deviation",
              "order": "descending"
            }
          ]
        },
        {
          "filter": "datum.peakRank <= 10"
        }
      ],
      "mark": {
        "type": "point",
        "filled": true,
        "color": "#E85D4A",
        "size": 90,
        "clip": true
      },
      "encoding": {
        "x": {
          "field": "year",
          "type": "quantitative"
        },
        "y": {
          "field": "deviation",
          "type": "quantitative"
        },
        "tooltip": [
          {
            "field": "year",
            "type": "quantitative",
            "title": "Année du pic",
            "format": "d"
          },
          {
            "field": "citations",
            "type": "quantitative",
            "title": "Nombre de références citées",
            "format": ".0f"
          },
          {
            "field": "median5",
            "type": "quantitative",
            "title": "Médiane sur cinq ans",
            "format": ".0f"
          },
          {
            "field": "deviation",
            "type": "quantitative",
            "title": "Écart à la médiane",
            "format": "+.0f"
          },
          {
            "field": "peakRank",
            "type": "quantitative",
            "title": "Rang du pic",
            "format": ".0f"
          }
        ]
      }
    },
    {
      "transform": [
        {
          "filter": "datum.deviation > 0 && datum.year >= 1879 && datum.year <= 2021"
        },
        {
          "window": [
            {
              "op": "rank",
              "as": "peakRank"
            }
          ],
          "sort": [
            {
              "field": "deviation",
              "order": "descending"
            }
          ]
        },
        {
          "filter": "datum.peakRank <= 10"
        }
      ],
      "mark": {
        "type": "text",
        "color": "#E85D4A",
        "fontSize": 12,
        "fontWeight": "bold",
        "dy": -13,
        "clip": true
      },
      "encoding": {
        "x": {
          "field": "year",
          "type": "quantitative"
        },
        "y": {
          "field": "deviation",
          "type": "quantitative"
        },
        "text": {
          "field": "year",
          "type": "quantitative",
          "format": "d"
        }
      }
    }
  ],
  "resolve": {
    "scale": {
      "x": "shared",
      "y": "shared"
    }
  },
  "config": {
    "view": {
      "stroke": null
    },
    "axis": {
      "labelFontSize": 12,
      "titleFontSize": 13
    }
  }
}
Interpréter le résultat
La courbe noire indique combien de références citées ont été publiées chaque année. La courbe rouge met en évidence les années dont la fréquence s’écarte de la médiane locale. Les points rouges signalent les plus forts écarts positifs dans la période affichée.
Une année remarquable peut correspondre à une publication très souvent citée, à plusieurs publications influentes parues la même année ou à un effet de composition du corpus. Pour savoir quels travaux expliquent un pic, il faut examiner les références bibliographiques correspondantes. Ce sera l’objet d’un autre cas d’usage.
Adapter le graphique à un autre corpus
- Modifier les bornes chronologiques dans le filtre initial,
keyvals, le domaine de l’axe horizontal et les filtres des points et étiquettes. Les bornes de calcul et d’affichage peuvent être différentes. - Adapter le nom du champ si les années de référence ne sont pas stockées dans
citedReferenceYears. - Adapter le nombre de pics affichés en remplaçant
peakRank <= 10par une autre valeur. - Adapter la taille du graphique avec
height, et les couleurs dans les propriétésmark.
Limites et précautions
La qualité de la RPYS dépend de la qualité du corpus initial, de la couverture des références par OpenAlex et de la récupération effective des données. Les références sans année ne sont pas comptées. Les variations d’écriture, les données bibliographiques incomplètes et les différences entre bases de données peuvent modifier les résultats.
À retenir
La RPYS part des bibliographies d’un corpus, compte les années de publication des références citées, puis compare les fréquences annuelles à une médiane glissante. Les pics constituent des indices pour retrouver les travaux importants dans l’histoire d’un domaine, à confirmer par une lecture bibliographique.
Identifier les 30 publications les plus citées dans un corpus

Quelles publications sont les plus souvent citées dans les bibliographies d’un corpus scientifique ? Ce cas d’usage propose de construire, dans Lodex, un classement des 30 publications les plus citées, représenté sous la forme d’un diagramme en barres horizontales avec Vega-Lite.
Ce cas d’usage s’appuie sur l’exemple précédent consacré à la RPYS (« Identifier les années marquantes d’un domaine scientifique avec la RPYS »). Nous reprenons le champ citedReferencesMetadata déjà créé et nous nous concentrons sur les opérations propres à ce nouveau graphique. Il n’est donc pas nécessaire de recommencer l’interrogation de l’API OpenAlex si ce champ est déjà disponible.
Comprendre ce que mesure le classement
Chaque document du corpus contient des références bibliographiques. Lorsqu’une même publication apparaît dans les bibliographies de plusieurs documents, elle est comptée autant de fois qu’elle est citée dans le corpus. Le graphique classe ensuite les publications selon ce nombre d’occurrences.
Document A → cite la publication X et la publication Y
Document B → cite la publication X
Document C → cite la publication X et la publication Z

Publication X → 3 citations dans le corpus
Publication Y → 1 citation dans le corpus
Publication Z → 1 citation dans le corpus
À retenir
Le nombre de citations représenté ici est calculé à l’intérieur du corpus étudié. Il ne correspond pas au nombre global de citations d’une publication dans OpenAlex (cited_by_count).
Préparer les données nécessaires
Nous partons du champ citedReferencesMetadata, produit par l’enrichissement du premier cas d’usage. Pour chaque document du corpus, ce champ contient un tableau de références citées, avec notamment leur identifiant OpenAlex, leur titre, leur année de publication et leurs auteurs.
[
  {
    "id": "https://openalex.org/W200000001",
    "title": "Exemple de publication citée",
    "year": 1986,
    "authors": [
      "Auteur A",
      "Auteur B"
    ],
    "doi": null,
    "cited_by_count": 120
  },
  {
    "id": "https://openalex.org/W200000002",
    "title": "Autre publication citée",
    "year": 2004,
    "authors": [
      "Auteur C"
    ],
    "doi": null,
    "cited_by_count": 85
  }
]
Ces données sont fictives et servent uniquement à illustrer la structure attendue. Si le champ citedReferencesMetadata n’existe pas encore dans votre instance, réalisez d’abord l’enrichissement de récupération des références décrit dans l’article RPYS.
Créer l’enrichissement citedReferenceDetails
Dans Lodex, créez un nouveau champ nommé citedReferenceDetails et utilisez l’enrichissement suivant en mode avancé.
[assign]
path = value
value = get("value.citedReferencesMetadata").map(ref => [ref.year, ref.title, ref.authors.join(", "), ref.id].join(" | "))
Comprendre la transformation
L’expression get("value.citedReferencesMetadata") récupère les références du document. La fonction map() parcourt ensuite chacune d’elles. Pour chaque référence, nous réunissons quatre informations dans un tableau : l’année (ref.year), le titre (ref.title), les auteurs (ref.authors.join(", ")) et l’identifiant OpenAlex (ref.id).
La dernière instruction join(" | ") rassemble ces informations dans une chaîne de caractères. Le séparateur | permettra ensuite à Vega-Lite de retrouver chaque élément séparément.
1986 | Exemple de publication citée | Auteur A, Auteur B | https://openalex.org/W200000001
2004 | Autre publication citée | Auteur C | https://openalex.org/W200000002
Le champ citedReferenceDetails contient donc un tableau de chaînes : une chaîne par référence citée dans chaque document du corpus. Contrairement à une liste de publications uniques, les répétitions entre documents sont conservées afin de mesurer leur fréquence.
Point de vigilance
Cette méthode suppose que les titres et les noms d’auteurs ne contiennent pas le caractère|, utilisé comme séparateur. Elle suppose également que les références disposent des champsyear,title,authorsetidsous la forme attendue. Pour des données très hétérogènes, il peut être nécessaire de normaliser ces champs en amont.
Créer la routine
Utilisez la routinedistinct-by sur le champ citedReferenceDetails. Elle regroupe les chaînes identiques et compte combien de fois chaque référence apparaît dans les documents du corpus.
[
  {
    "_id": "1986 | Exemple de publication citée | Auteur A, Auteur B | https://openalex.org/W200000001",
    "value": 12
  },
  {
    "_id": "2004 | Autre publication citée | Auteur C | https://openalex.org/W200000002",
    "value": 8
  }
]
Dans ce résultat fictif, _id identifie la référence bibliographique et value indique son nombre de citations dans le corpus. Une même publication doit conserver la même chaîne pour être correctement regroupée. L’identifiant OpenAlex contribue à distinguer les publications qui auraient des titres semblables.
Préparer le classement dans Vega-Lite
Le graphique reçoit les résultats de la routine et réalise plusieurs transformations pour construire le classement.
Récupérer les informations bibliographiques
{"calculate": "toNumber(trim(split(datum._id, '|')[0]))", "as": "year"},
{"calculate": "trim(split(datum._id, '|')[1])", "as": "title"},
{"calculate": "trim(split(datum._id, '|')[2])", "as": "authors"},
{"calculate": "trim(split(datum._id, '|')[3])", "as": "openalexId"},
{"calculate": "toNumber(datum.value)", "as": "citations"}
La fonction split() sépare la chaîne _id à chaque caractère |. Les indices [0], [1], [2] et [3] désignent les quatre éléments obtenus. La fonction trim() supprime les espaces inutiles autour des valeurs. La fonction toNumber() convertit les années et les fréquences en nombres.
Classer les références et retenir les trente premières
{
  "window": [{"op": "row_number", "as": "rank"}],
  "sort": [{"field": "citations", "order": "descending"}]
},
{"filter": "datum.rank <= 30"}
row_number attribue un rang à chaque publication après tri décroissant sur le nombre de citations. Le filtre conserve les 30 premières. En cas d’égalité, l’ordre entre publications ex æquo n’est pas explicitement départagé par ce code.
Construire les libellés du graphique
{"calculate": "datum.year + ' — ' + datum.title", "as": "referenceLabel"}Chaque barre porte un libellé composé de l’année de publication suivie du titre. Les titres longs peuvent être tronqués sur l’axe vertical pour préserver la lisibilité ; l’infobulle permet de consulter le titre complet et les autres métadonnées.
Créer le graphique Vega-Lite
Créez un graphique de type « Graphique – Syntaxe Vega-Lite » en utilisant les résultats de la routine distinct-by appliquée à citedReferenceDetails. Le graphique présente les publications en ordonnée et le nombre de citations dans le corpus en abscisse. Les barres sont classées de la plus citée à la moins citée.
Au survol d’une barre, une infobulle affiche le titre, les auteurs, l’année, le nombre de citations dans le corpus et l’identifiant OpenAlex. Les titres bibliographiques restent dans leur langue d’origine.
Code complet du graphique Vega-Lite
{
  "$schema": "https://vega.github.io/schema/vega-lite/v5.json",
  "width": "container",
  "height": 850,
  "background": "transparent",
  "transform": [
    {
      "calculate": "toNumber(trim(split(datum._id, '|')[0]))",
      "as": "year"
    },
    {
      "calculate": "trim(split(datum._id, '|')[1])",
      "as": "title"
    },
    {
      "calculate": "trim(split(datum._id, '|')[2])",
      "as": "authors"
    },
    {
      "calculate": "trim(split(datum._id, '|')[3])",
      "as": "openalexId"
    },
    {
      "calculate": "toNumber(datum.value)",
      "as": "citations"
    },
    {
      "filter": "isValid(datum.year) && isValid(datum.citations)"
    },
    {
      "window": [
        {
          "op": "row_number",
          "as": "rank"
        }
      ],
      "sort": [
        {
          "field": "citations",
          "order": "descending"
        }
      ]
    },
    {
      "filter": "datum.rank <= 30"
    },
    {
      "calculate": "datum.year + ' — ' + datum.title",
      "as": "referenceLabel"
    }
  ],
  "mark": {
    "type": "bar",
    "color": "#458CCC",
    "cornerRadiusEnd": 4
  },
  "encoding": {
    "y": {
      "field": "referenceLabel",
      "type": "nominal",
      "sort": {
        "field": "citations",
        "order": "descending"
      },
      "title": null,
      "axis": {
        "labelLimit": 350,
        "labelFontSize": 11
      }
    },
    "x": {
      "field": "citations",
      "type": "quantitative",
      "title": "Nombre de citations dans le corpus",
      "axis": {
        "tickMinStep": 1
      }
    },
    "tooltip": [
      {
        "field": "title",
        "title": "Titre de la publication"
      },
      {
        "field": "authors",
        "title": "Auteurs"
      },
      {
        "field": "year",
        "title": "Année de publication",
        "format": "d"
      },
      {
        "field": "citations",
        "title": "Nombre de citations dans le corpus",
        "format": ".0f"
      },
      {
        "field": "openalexId",
        "title": "Identifiant OpenAlex"
      }
    ]
  },
  "config": {
    "view": {
      "stroke": null
    },
    "axis": {
      "labelFontSize": 12,
      "titleFontSize": 13
    }
  }
}
Interpréter le résultat
Ce classement met en évidence les publications les plus fréquemment mobilisées par les documents du corpus. Il peut aider à repérer des travaux de référence, à identifier des auteurs souvent cités et à préparer une analyse bibliographique plus approfondie.
Il ne faut toutefois pas confondre publication très citée et publication fondatrice : la fréquence dépend de la composition du corpus, de sa période, de la couverture bibliographique d’OpenAlex et des pratiques de citation du domaine.
Adapter le graphique
- Modifier le nombre de publications : remplacez
datum.rank <= 30par la limite souhaitée. - Adapter la hauteur : modifiez
heightpour laisser suffisamment de place aux libellés. - Modifier la couleur : changez la propriété
colordu blocmark. - Modifier la longueur des libellés : ajustez
labelLimitdans l’axe vertical.
Limites et précautions
Le classement ne porte que sur les références récupérées et identifiées dans OpenAlex. Les références absentes, les erreurs d’enrichissement et les métadonnées incomplètes peuvent modifier les résultats. Le regroupement repose ici sur une chaîne bibliographique : une variation de titre ou d’auteur peut empêcher deux occurrences d’être regroupées, même si elles désignent le même travail.
À retenir
Ce deuxième cas d’usage complète la RPYS : au lieu de rechercher les années les plus remarquables dans les bibliographies, nous identifions les publications les plus fréquemment citées dans le corpus. Les deux graphiques utilisent les mêmes références OpenAlex, mais répondent à des questions différentes.
Identifier les publications associées aux pics de citations avec la RPYS

Une année particulièrement citée dans les bibliographies d’un corpus peut correspondre à un travail majeur ou à plusieurs publications importantes. Mais comment retrouver les publications qui contribuent à ces pics ? Ce troisième cas d’usage combine la Reference Publication Year Spectroscopy (RPYS) et les informations bibliographiques récupérées depuis OpenAlex pour annoter automatiquement certaines années remarquables dans un graphique Vega-Lite.
Cet exemple prolonge les deux précédents : le premier expliquait comment calculer une RPYS à partir des années des références citées ; le deuxième montrait comment classer les 30 publications les plus citées. Nous reprenons ici le champ citedReferenceDetails et sa routine distinct-by, sans répéter les étapes de récupération des références OpenAlex.
Comprendre le principe du graphique
Le graphique superpose deux courbes : le nombre de citations bibliographiques par année et l’écart à une médiane glissante sur cinq ans. Il recherche ensuite les années présentant un pic local suffisamment marqué, puis indique pour certaines d’entre elles la publication la plus fréquemment citée dans le corpus cette année-là.
À retenir
Une année peut présenter un pic parce qu’une seule publication est très citée, mais aussi parce que plusieurs publications parues cette année-là le sont. L’étiquette affichée correspond à la publication la plus citée de l’année dans notre corpus ; elle ne démontre pas à elle seule que cette publication explique l’intégralité du pic.
Réutiliser les données préparées dans les exemples précédents
Le point de départ est le champ citedReferencesMetadata, créé lors du premier exemple. Il contient, pour chaque document du corpus, les références récupérées depuis OpenAlex : identifiant, titre, année et auteurs notamment.
Comme dans le deuxième cas d’usage, nous créons un enrichissement citedReferenceDetails en mode avancé. Si ce champ existe déjà, il n’est pas nécessaire de relancer cet enrichissement.
[assign]
path = value
value = get("value.citedReferencesMetadata").map(ref => [ref.year, ref.title, ref.authors.join(", "), ref.id].join(" | "))
Pour chaque référence, l’instruction rassemble l’année, le titre, les auteurs et l’identifiant OpenAlex dans une chaîne de caractères, séparés par | . Les répétitions entre documents sont conservées pour pouvoir compter les citations.
1986 | Exemple de publication citée | Auteur A, Auteur B | https://openalex.org/W200000001
2004 | Autre publication citée | Auteur C | https://openalex.org/W200000002
Ces exemples sont fictifs. La méthode suppose que le caractère | n’apparaît pas dans les titres ou les auteurs ; sinon, le découpage des informations dans Vega-Lite devra être adapté.
Créer la routine
Utilisez la routine distinct-by sur le champ citedReferenceDetails. Elle compte les occurrences de chaque chaîne bibliographique dans l’ensemble du corpus. Il s’agit de la même routine que pour le graphique des 30 publications les plus citées.
[
  {
    "_id": "1986 | Exemple de publication citée | Auteur A, Auteur B | https://openalex.org/W200000001",
    "value": 12
  },
  {
    "_id": "2004 | Autre publication citée | Auteur C | https://openalex.org/W200000002",
    "value": 8
  }
]
La propriété _id contient la référence bibliographique ; value contient son nombre de citations dans le corpus étudié, et non le nombre global de citations OpenAlex.
Retrouver les fréquences annuelles
À la différence du premier graphique RPYS, nous ne partons pas directement d’un tableau d’années. Nous disposons d’un résultat par publication citée. Il faut donc additionner les citations de toutes les publications parues la même année.
{
  "joinaggregate": [
    {
      "op": "sum",
      "field": "citations",
      "as": "annualCitations"
    }
  ],
  "groupby": [
    "year"
  ]
}
Après extraction de l’année et conversion de value en nombre, joinaggregate calcule annualCitations, c’est-à-dire le total des occurrences de références publiées une année donnée. Contrairement à une agrégation classique, cette instruction conserve les lignes des publications, ce qui permet ensuite de retrouver leurs titres. Voir la documentation Vega-Lite sur joinaggregate.
Identifier la publication la plus citée de chaque année
{
  "window": [
    {
      "op": "row_number",
      "as": "workRank"
    }
  ],
  "groupby": [
    "year"
  ],
  "sort": [
    {
      "field": "citations",
      "order": "descending"
    },
    {
      "field": "openalexId",
      "order": "ascending"
    }
  ]
}
{"filter": "datum.workRank == 1"}
Les publications sont classées par nombre de citations, séparément pour chaque année. Nous conservons la première de chaque groupe, avec son titre, ses auteurs et son identifiant. Le total annuel calculé précédemment reste disponible. En cas d’égalité, l’identifiant OpenAlex sert ici à départager les publications de manière déterministe.
Calculer les pics de citations
Compléter les années et calculer la médiane
Les années absentes sont complétées par zéro citation, puis une médiane glissante sur cinq ans est calculée. Le graphique utilise la période 1818–2021 pour les calculs et affiche les années 1870–2021. Ces bornes sont celles de cet exemple et doivent être adaptées au corpus.
[
  {
    "impute": "annualCitations",
    "key": "year",
    "keyvals": {
      "start": 1818,
      "stop": 2022,
      "step": 1
    },
    "value": 0
  },
  {
    "window": [
      {
        "op": "median",
        "field": "annualCitations",
        "as": "median5"
      }
    ],
    "sort": [
      {
        "field": "year",
        "order": "ascending"
      }
    ],
    "frame": [
      -2,
      2
    ]
  },
  {
    "calculate": "datum.annualCitations - datum.median5",
    "as": "deviation"
  }
]
L’écart à la médiane, appelé deviation, permet de repérer les années dont la fréquence de citation dépasse celle de leur voisinage. Les calculs utilisent des années consécutives grâce à impute.
Détecter les maxima locaux
[
  {
    "window": [
      {
        "op": "lag",
        "field": "deviation",
        "as": "previousDeviation"
      },
      {
        "op": "lead",
        "field": "deviation",
        "as": "nextDeviation"
      }
    ],
    "sort": [
      {
        "field": "year",
        "order": "ascending"
      }
    ]
  },
  {
    "filter": "datum.year >= 1870 && datum.year <= 2021 && datum.deviation >= 10 && isValid(datum.previousDeviation) && isValid(datum.nextDeviation) && datum.deviation > datum.previousDeviation && datum.deviation > datum.nextDeviation && isValid(datum.title)"
  }
]
Les fonctions lag et lead récupèrent respectivement l’écart de l’année précédente et de l’année suivante. Nous retenons une année si son écart à la médiane est au moins égal à 10 et strictement supérieur à ceux de ses deux voisines. Il s’agit d’un seuil choisi pour cette visualisation, et non d’une règle universelle de la RPYS.
Limiter le nombre d’annotations
Pour éviter que les étiquettes se superposent, le graphique retient au maximum huit pics, répartis entre trois périodes : deux avant 1950, trois entre 1950 et 1989 et trois depuis 1990. Dans chaque période, les pics sont classés par écart décroissant.
[
  {
    "calculate": "datum.year < 1950 ? 'Avant 1950' : datum.year < 1990 ? '1950–1989' : 'Depuis 1990'",
    "as": "period"
  },
  {
    "window": [
      {
        "op": "row_number",
        "as": "periodRank"
      }
    ],
    "groupby": [
      "period"
    ],
    "sort": [
      {
        "field": "deviation",
        "order": "descending"
      }
    ]
  },
  {
    "filter": "(datum.period == 'Avant 1950' && datum.periodRank <= 2) || (datum.period == '1950–1989' && datum.periodRank <= 3) || (datum.period == 'Depuis 1990' && datum.periodRank <= 3)"
  }
]
Cette répartition est un choix de lisibilité, valable pour le corpus qui fait office d’exemple. Elle ne signifie pas que les périodes ont la même importance scientifique. Si une période ne comporte pas assez de pics répondant aux critères, moins de huit annotations peuvent apparaître.
Afficher les publications sur le graphique
Chaque point sélectionné est accompagné d’une étiquette composée du premier auteur disponible et de l’année de publication. Au survol, l’infobulle présente aussi le titre complet, les auteurs, le nombre de citations de cette publication dans le corpus et le total des citations de l’année.
La courbe grise représente les fréquences annuelles ; la courbe olive représente les écarts à la médiane. Les points et leurs étiquettes sont placés sur les maxima locaux retenus.
Code complet du graphique Vega-Lite
Dans Lodex, créez une visualisation Vega-Lite alimentée par la routine distinct-by sur citedReferenceDetails, puis collez la configuration suivante.
{
  "$schema": "https://vega.github.io/schema/vega-lite/v5.json",
  "width": "container",
  "height": 430,
  "background": "transparent",
  "transform": [
    {
      "calculate": "toNumber(trim(split(datum._id, '|')[0]))",
      "as": "year"
    },
    {
      "calculate": "trim(split(datum._id, '|')[1])",
      "as": "title"
    },
    {
      "calculate": "trim(split(datum._id, '|')[2])",
      "as": "authors"
    },
    {
      "calculate": "trim(split(datum._id, '|')[3])",
      "as": "openalexId"
    },
    {
      "calculate": "toNumber(datum.value)",
      "as": "citations"
    },
    {
      "filter": "isValid(datum.year) && datum.year >= 1818 && datum.year <= 2021 && isValid(datum.citations)"
    },
    {
      "joinaggregate": [
        {
          "op": "sum",
          "field": "citations",
          "as": "annualCitations"
        }
      ],
      "groupby": [
        "year"
      ]
    },
    {
      "window": [
        {
          "op": "row_number",
          "as": "workRank"
        }
      ],
      "groupby": [
        "year"
      ],
      "sort": [
        {
          "field": "citations",
          "order": "descending"
        },
        {
          "field": "openalexId",
          "order": "ascending"
        }
      ]
    },
    {
      "filter": "datum.workRank == 1"
    },
    {
      "impute": "annualCitations",
      "key": "year",
      "keyvals": {
        "start": 1818,
        "stop": 2022,
        "step": 1
      },
      "value": 0
    },
    {
      "window": [
        {
          "op": "median",
          "field": "annualCitations",
          "as": "median5"
        }
      ],
      "sort": [
        {
          "field": "year",
          "order": "ascending"
        }
      ],
      "frame": [
        -2,
        2
      ]
    },
    {
      "calculate": "datum.annualCitations - datum.median5",
      "as": "deviation"
    },
    {
      "window": [
        {
          "op": "lag",
          "field": "deviation",
          "as": "previousDeviation"
        },
        {
          "op": "lead",
          "field": "deviation",
          "as": "nextDeviation"
        }
      ],
      "sort": [
        {
          "field": "year",
          "order": "ascending"
        }
      ]
    }
  ],
  "layer": [
    {
      "mark": {
        "type": "line",
        "color": "#555555",
        "strokeWidth": 2,
        "clip": true
      },
      "encoding": {
        "x": {
          "field": "year",
          "type": "quantitative",
          "title": "Année de publication des références",
          "scale": {
            "domain": [
              1870,
              2021
            ],
            "nice": false,
            "zero": false
          },
          "axis": {
            "format": "d",
            "tickMinStep": 1
          }
        },
        "y": {
          "field": "annualCitations",
          "type": "quantitative",
          "title": "Nombre de références citées"
        },
        "tooltip": [
          {
            "field": "year",
            "type": "quantitative",
            "title": "Année",
            "format": "d"
          },
          {
            "field": "annualCitations",
            "type": "quantitative",
            "title": "Références citées",
            "format": ".0f"
          },
          {
            "field": "median5",
            "type": "quantitative",
            "title": "Médiane sur cinq ans",
            "format": ".0f"
          },
          {
            "field": "deviation",
            "type": "quantitative",
            "title": "Écart à la médiane",
            "format": "+.0f"
          }
        ]
      }
    },
    {
      "mark": {
        "type": "line",
        "color": "#8D8B45",
        "strokeWidth": 2,
        "clip": true
      },
      "encoding": {
        "x": {
          "field": "year",
          "type": "quantitative"
        },
        "y": {
          "field": "deviation",
          "type": "quantitative"
        },
        "tooltip": [
          {
            "field": "year",
            "type": "quantitative",
            "title": "Année",
            "format": "d"
          },
          {
            "field": "annualCitations",
            "type": "quantitative",
            "title": "Références citées",
            "format": ".0f"
          },
          {
            "field": "median5",
            "type": "quantitative",
            "title": "Médiane sur cinq ans",
            "format": ".0f"
          },
          {
            "field": "deviation",
            "type": "quantitative",
            "title": "Écart à la médiane",
            "format": "+.0f"
          }
        ]
      }
    },
    {
      "transform": [
        {
          "filter": "datum.year >= 1870 && datum.year <= 2021 && datum.deviation >= 10 && isValid(datum.previousDeviation) && isValid(datum.nextDeviation) && datum.deviation > datum.previousDeviation && datum.deviation > datum.nextDeviation && isValid(datum.title)"
        },
        {
          "calculate": "datum.year < 1950 ? 'Avant 1950' : datum.year < 1990 ? '1950–1989' : 'Depuis 1990'",
          "as": "period"
        },
        {
          "window": [
            {
              "op": "row_number",
              "as": "periodRank"
            }
          ],
          "groupby": [
            "period"
          ],
          "sort": [
            {
              "field": "deviation",
              "order": "descending"
            }
          ]
        },
        {
          "filter": "(datum.period == 'Avant 1950' && datum.periodRank <= 2) || (datum.period == '1950–1989' && datum.periodRank <= 3) || (datum.period == 'Depuis 1990' && datum.periodRank <= 3)"
        },
        {
          "calculate": "trim(split(datum.authors, ',')[0])",
          "as": "firstAuthor"
        },
        {
          "calculate": "(datum.firstAuthor && datum.firstAuthor != '' ? datum.firstAuthor : datum.title) + ' (' + datum.year + ')'",
          "as": "label"
        }
      ],
      "mark": {
        "type": "point",
        "filled": true,
        "color": "#B24C39",
        "size": 75,
        "clip": true
      },
      "encoding": {
        "x": {
          "field": "year",
          "type": "quantitative"
        },
        "y": {
          "field": "deviation",
          "type": "quantitative"
        },
        "tooltip": [
          {
            "field": "year",
            "type": "quantitative",
            "title": "Année",
            "format": "d"
          },
          {
            "field": "annualCitations",
            "type": "quantitative",
            "title": "Références citées",
            "format": ".0f"
          },
          {
            "field": "median5",
            "type": "quantitative",
            "title": "Médiane sur cinq ans",
            "format": ".0f"
          },
          {
            "field": "deviation",
            "type": "quantitative",
            "title": "Écart à la médiane",
            "format": "+.0f"
          },
          {
            "field": "title",
            "title": "Publication la plus citée cette année"
          },
          {
            "field": "authors",
            "title": "Auteurs"
          },
          {
            "field": "citations",
            "title": "Citations de cette publication",
            "format": ".0f"
          },
          {
            "field": "openalexId",
            "title": "Identifiant OpenAlex"
          }
        ]
      }
    },
    {
      "transform": [
        {
          "filter": "datum.year >= 1870 && datum.year <= 2021 && datum.deviation >= 10 && isValid(datum.previousDeviation) && isValid(datum.nextDeviation) && datum.deviation > datum.previousDeviation && datum.deviation > datum.nextDeviation && isValid(datum.title)"
        },
        {
          "calculate": "datum.year < 1950 ? 'Avant 1950' : datum.year < 1990 ? '1950–1989' : 'Depuis 1990'",
          "as": "period"
        },
        {
          "window": [
            {
              "op": "row_number",
              "as": "periodRank"
            }
          ],
          "groupby": [
            "period"
          ],
          "sort": [
            {
              "field": "deviation",
              "order": "descending"
            }
          ]
        },
        {
          "filter": "(datum.period == 'Avant 1950' && datum.periodRank <= 2) || (datum.period == '1950–1989' && datum.periodRank <= 3) || (datum.period == 'Depuis 1990' && datum.periodRank <= 3)"
        },
        {
          "calculate": "trim(split(datum.authors, ',')[0])",
          "as": "firstAuthor"
        },
        {
          "calculate": "(datum.firstAuthor && datum.firstAuthor != '' ? datum.firstAuthor : datum.title) + ' (' + datum.year + ')'",
          "as": "label"
        }
      ],
      "mark": {
        "type": "text",
        "color": "#7C3F31",
        "fontSize": 11,
        "fontWeight": "bold",
        "dy": -14,
        "clip": false
      },
      "encoding": {
        "x": {
          "field": "year",
          "type": "quantitative"
        },
        "y": {
          "field": "deviation",
          "type": "quantitative"
        },
        "text": {
          "field": "label",
          "type": "nominal"
        },
        "tooltip": [
          {
            "field": "year",
            "type": "quantitative",
            "title": "Année",
            "format": "d"
          },
          {
            "field": "annualCitations",
            "type": "quantitative",
            "title": "Références citées",
            "format": ".0f"
          },
          {
            "field": "median5",
            "type": "quantitative",
            "title": "Médiane sur cinq ans",
            "format": ".0f"
          },
          {
            "field": "deviation",
            "type": "quantitative",
            "title": "Écart à la médiane",
            "format": "+.0f"
          },
          {
            "field": "title",
            "title": "Publication la plus citée cette année"
          },
          {
            "field": "authors",
            "title": "Auteurs"
          },
          {
            "field": "citations",
            "title": "Citations de cette publication",
            "format": ".0f"
          },
          {
            "field": "openalexId",
            "title": "Identifiant OpenAlex"
          }
        ]
      }
    }
  ],
  "resolve": {
    "scale": {
      "x": "shared",
      "y": "shared"
    }
  },
  "config": {
    "view": {
      "stroke": null
    },
    "axis": {
      "labelFontSize": 12,
      "titleFontSize": 13
    }
  }
}
Adapter la visualisation
- Période chronologique : modifiez le filtre des années, les bornes de
keyvals, le domaine de l’axe horizontal et le filtre des pics. - Seuil de détection : modifiez
datum.deviation >= 10pour rendre la sélection plus ou moins restrictive. - Nombre d’annotations : modifiez les limites
periodRanket, si nécessaire, les trois périodes historiques. - Présentation : adaptez les couleurs, la hauteur du graphique et la taille des étiquettes.
Interpréter les résultats et leurs limites
Les annotations facilitent l’exploration des références associées aux années remarquables. Elles ne prouvent pas qu’une publication soit à elle seule à l’origine d’un pic : plusieurs références publiées la même année peuvent contribuer au total. Le seuil de détection et la répartition des annotations influencent également les noms affichés.
Enfin, les résultats dépendent du corpus initial et de la couverture des références par OpenAlex. Une référence absente de l’index, non récupérée par l’API ou sans année exploitable peut manquer au comptage. La lecture des travaux et leur mise en contexte restent indispensables pour interpréter les pics.
À retenir
Ce troisième graphique relie les deux approches précédentes : la RPYS met en évidence les années particulièrement citées, tandis que les métadonnées bibliographiques permettent de retrouver, pour chaque année sélectionnée, une publication à examiner en priorité.