GRAPHIQUE-Aster Plot
Routine utilisable
- close-by
- sub-resources-asterplot
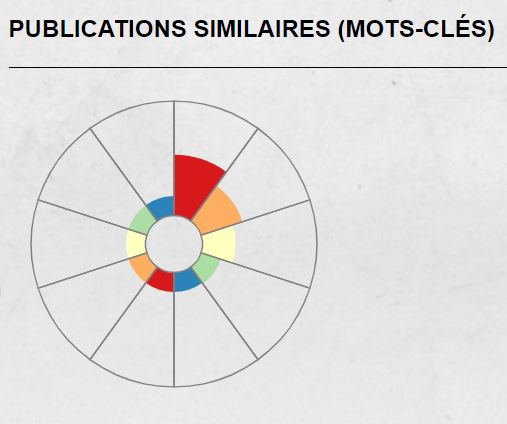
Ce format permet de faire un graphique sur le champ multivalué textuel « mots-clés », dans la ressource, et non au niveau du jeu de données, pour visualiser les ressources qui ont le plus de similarité entre elles .
-créer un champ ressource X (exemple : mots-clés auteur, indexation Teeft, entités nommées Unitex)
– transformers : PARSE / CAPITALIZE, éventuellement homogénéiser avec des REPLACE Biomimetisme, Bio-mimétisme….=> Biomimétisme
– format : liste de valeurs désordonnée
-créer un champ graphique (dans page Ressource )
– valeur : /api/run/close-by/id-du-champ-ressource X
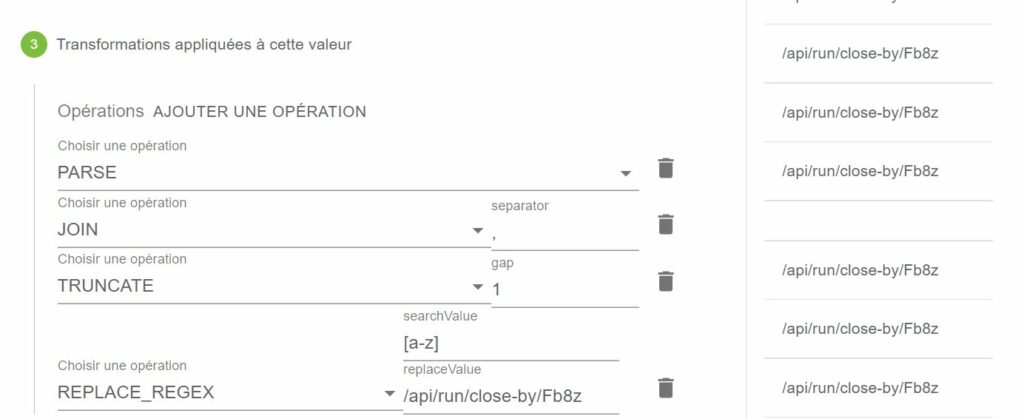
-choisir des transformateurs : PARSE/JOIN/TRUNCATE et REPLACE_REGEX => api/run/close-by/id-du-champ-ressource X
-Choisir le format « graphique-Aster Plot »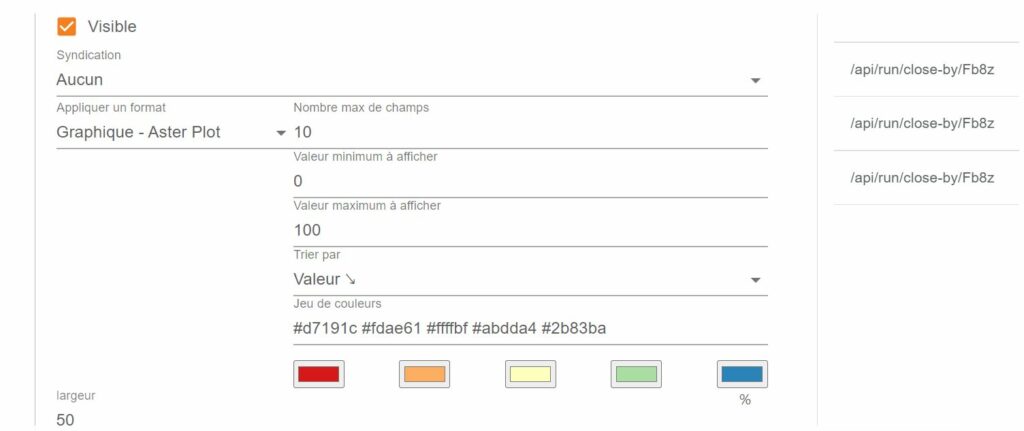
-Résultat : en cliquant sur les quartiers on accède à la ressource
Cas particulier du « graphique-Aster Plot de sous ressource »
-Dans sous ressource créer un champ « Y »
-Dans sous ressource créer un champ graphique : comment la valeur est créée une valuer arbitraire /api/run/sub-resources-asterplot/X/Y
X= étant l’intitulé du champ lié à la sous ressource dans les ressources et Y l’intitulé du champ sous ressource.(ex: oeSQ..)
-Choisir ensuite le format « Graphique- Aster Plot »
GRAPHIQUE-Carte de chaleur
Routine utilisable
- pairing-with
- graph-by
- cross-by
- decompose-by
Paramétrage disponible
–Nombre max de champs
Nombre de champs maximum retourné par la routine, vide et équivalent à l’infini (si la routine le permet)
–Valeur minimum à afficher & Valeur maximum à afficher
Encadrement des valeurs retournés par la routine, vide et équivalent à l’infini [-∞, +∞] (si la routine le permet)
– Trier par
Trie les données retournées par la routine sur leur intitulé ou leurs valeur (si la routine le permet)
Note : le tri par valeur peut ne pas fonctionner car il s’agit d’association de valeurs
– Afficher l’info-bulle
permet de mettre une info-bulle sur les données du graphique avec un titre sur les intitulés et valeurs des données.
– Jeu de couleurs
Sélection d’une palette de couleur en dégradé
– Inverser les axes
Inverser les deux axes la source devient la destination et la destination devient la source
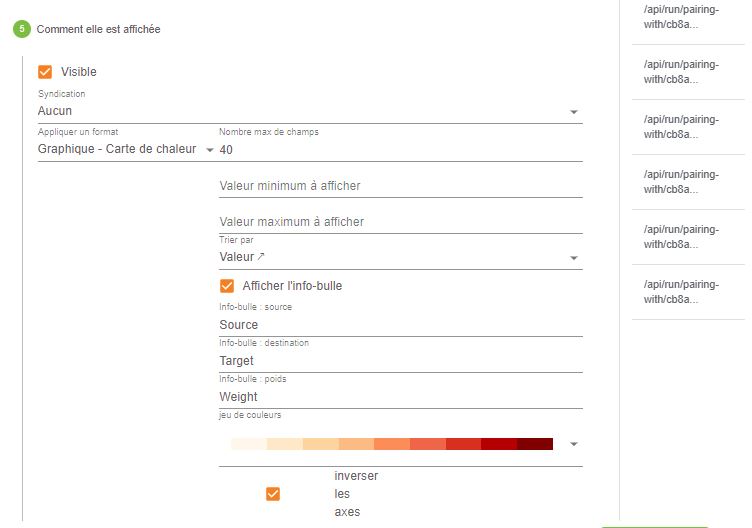
=> Exemple /api/run/pairing-with/FFnf/cb8a
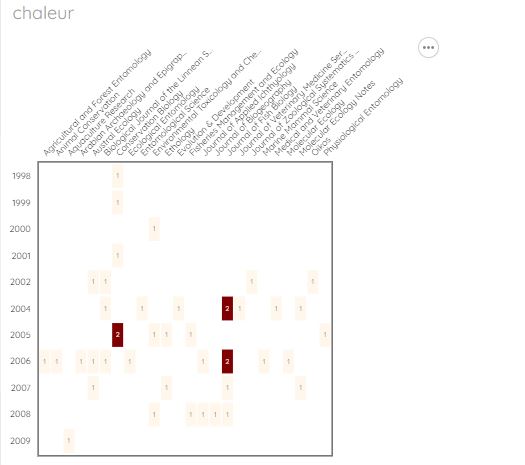

Comme pour tous les graphiques en fonction des valeurs dans le paramétrage le graphique peut ne pas s’afficher. Dans l’exemple ci-dessous Nombre max de champs = 100, pas d’affichage
GRAPHIQUE-Cartographie
Routine utilisable
- distinct-by
- distinct-ISO3166-1-alpha3-from
- distinct-alpha-2-alpha3-from
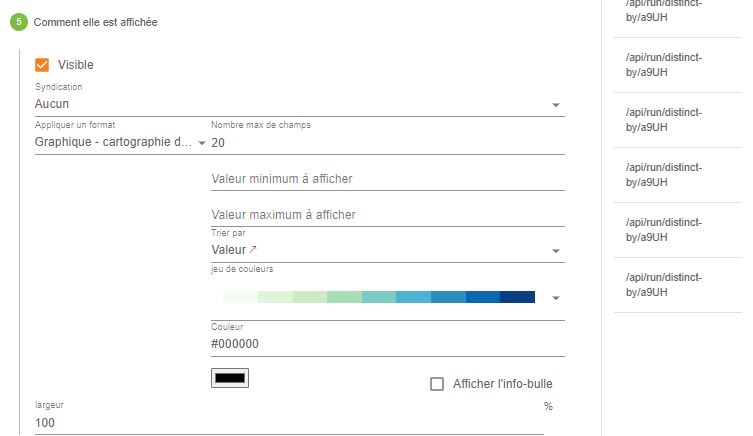
Paramétrage disponible
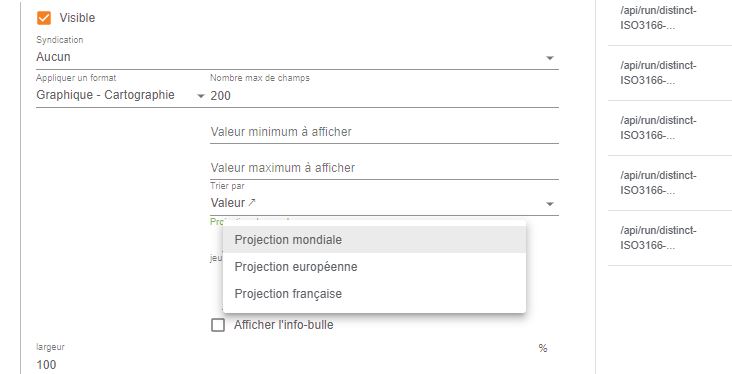
-Projection du monde
Ce paramètre correspond au zoom effectué sur la carte, 3 zoom sont disponibles
Projection mondiale : Affiche le monde
Projection européenne : Affiche l’europe géographique
Projection français : Afficher la france avec ces départements
-Jeu de couleurs
Dégradé de couleur qui est appliqué au poids d’un pays/département
-Afficher l’info-bulle
permet de mettre une info-bulle sur les données du graphique avec un titre sur les intitulés et valeurs des données.
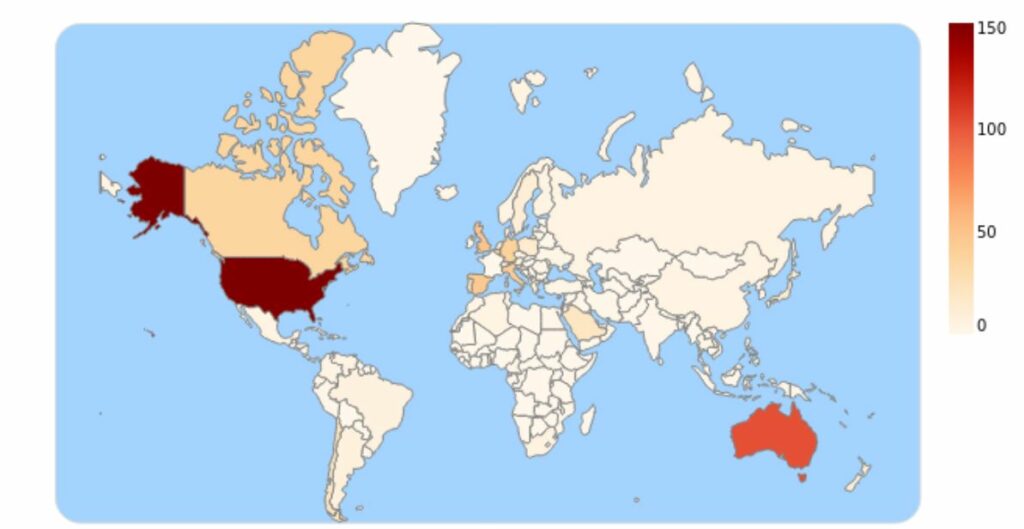
GRAPHIQUE-cartographie de flux
Routine utilisable
- pairing-with
- graph-by
- cross-by
- decompose-by
Paramétrage disponible
-Nombre max de champs
Nombre de champs maximum retourné par la routine, vide et équivalent à l’infini (si la routine le permet)
–Valeur minimum à afficher & Valeur maximum à afficher
Encadrement des valeur retourné par la routine, vide et équivalent à l’infini [-∞, +∞] (si la routine le permet)
-Trier par
Trie les données retournées par la routine sur leur intitulé ou leurs valeur (si la routine le permet)
Note : le tri par valeur peut ne pas fonctionner car il s’agit d’association de valeur
-Afficher l’info-bulle
permet de mettre une info-bulle sur les données du graphique avec un titre sur les intitulés et valeurs des données.
-Jeu de couleurs
Dégradé de couleur sur les point
-Couleur
Couleur des lien données en code hexadécimal
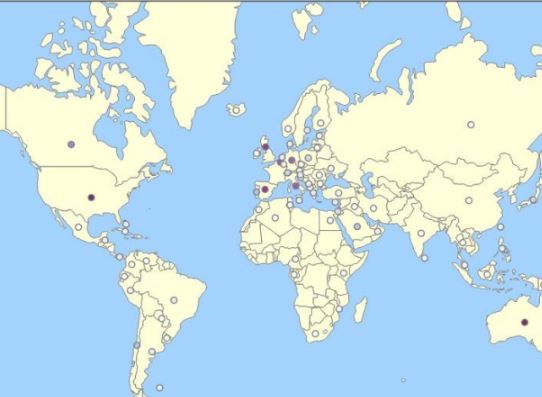
Carte des flux sans survol des nœuds
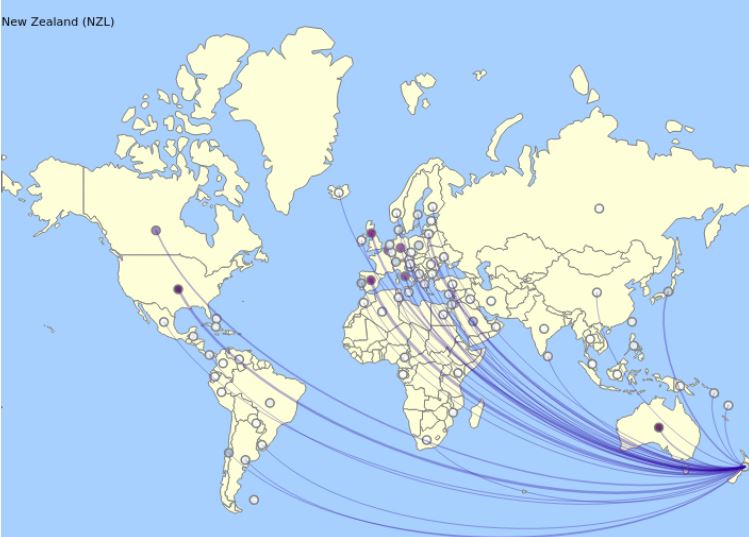
Carte des flux avec survol des nœuds
GRAPHIQUE-Coordonnées parallèles
Format de graphique sur plusieurs champs monovalués ou multivalués, textuels ou numériques et comme pour l’asterplot c’est un graphique qui s’affiche dans une ressource et non sur un jeu de données.
Calcule pour chaque champ une similarité, puis il fait une moyenne : calcule la distance entre le doc courant et les autres docs
-> calcule le pourcentage de similarité entre les documents
-> le problème est qu’il risque de calculer 1 doc avec tout le reste
On peut mixer les champs mono ou multivalués, on aura toujours des résultats
Pour les champs numériques, il faut absolument les coupler avec un transformer NUMBER
Pour les champs textuels, calcule une distance de Levenstein
(=comparaison de chaînes de caractère => nombre d’opérations qu’il faut pour se retrouver d’un mot à l’autre)
Routine utilisable
- distance with
Paramétrage disponible
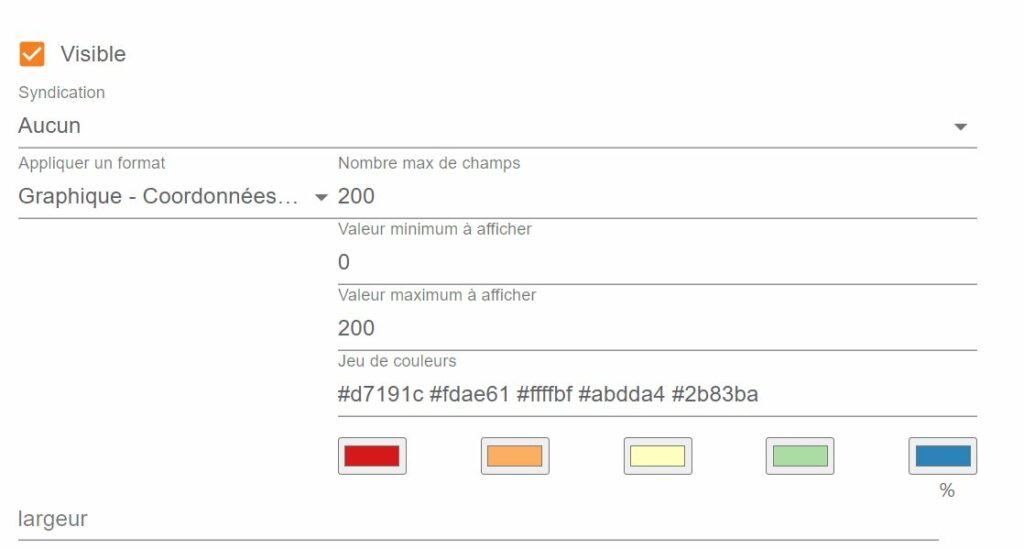
-Comment la valeur est créée
=> Exemple /api/run/distance-with/zoQ1/aljG/NzLI/LzSz/

-Comment elle est affichée
Faire varier le nombre des champ pour voir l’affichage du graphe le plus lisible.
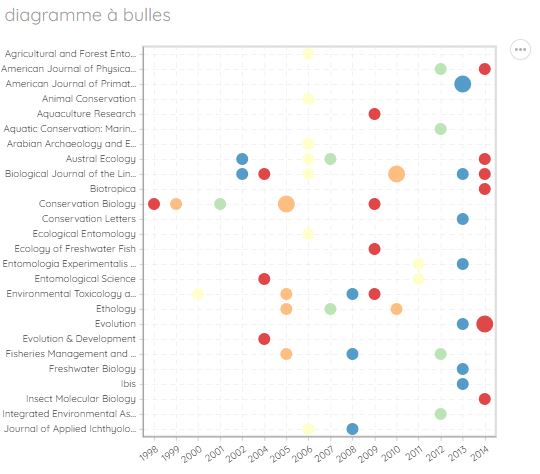
GRAPHIQUE-diagrammes à bulles
Routine utilisable
- pairing-with
- graph-by
- cross-by
- decompose-by
Paramétrage disponible
–Nombre max de champs
Nombre de champs maximum retournés par la routine, vide et équivalent à l’infini (si la routine le permet)
-Valeur minimum à afficher & Valeur maximum à afficher
Encadrement des valeurs retournées par la routine, vide et équivalent à l’infini [-∞, +∞] (si la routine le permet)
-Trier par
Trie les données retournées par la routine sur leur intitulé ou leurs valeurs(si la routine le permet)
Note : le tri par valeur peut ne pas fonctionner car il s’agit d’association de valeurs
-Afficher l’info-bulle
permet de mettre une info-bulle sur les données du graphique avec un titre sur les intitulés et valeurs des données.
-Jeu de couleurs
Couleur du graphique donnée en code hexadécimal
-Inverser les axes
Inverser les deux axes la source devient la destination et la destination devient la source
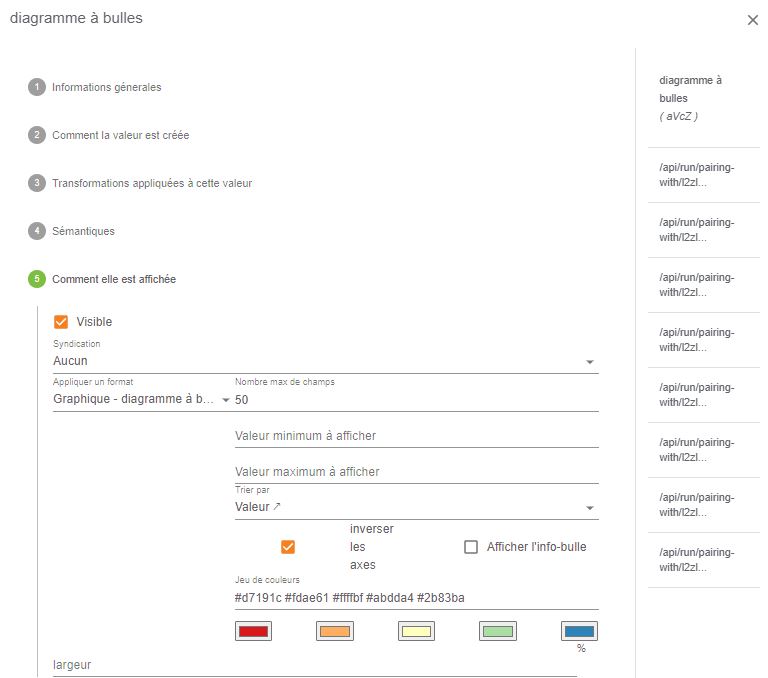
=>Exemple /api/run/pairing-with/l2zl/cb8a
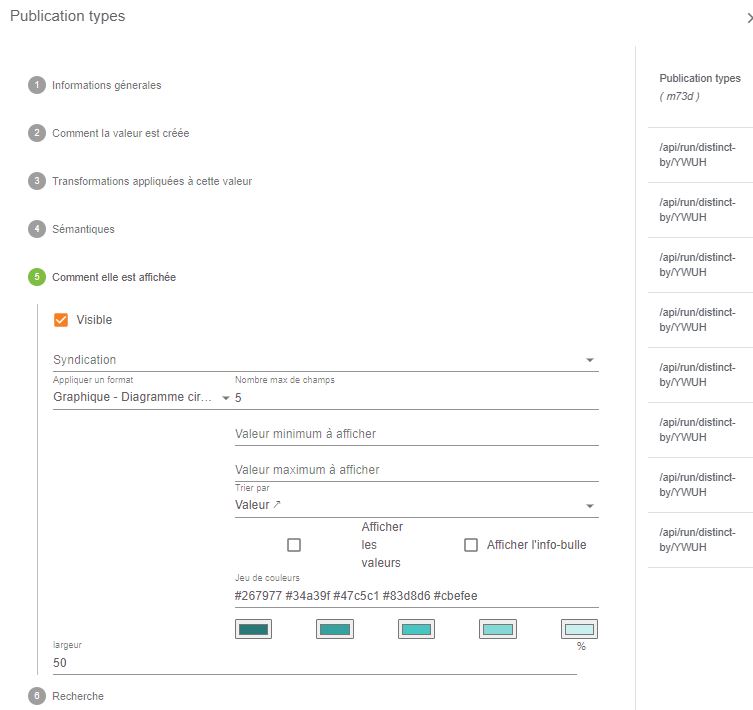
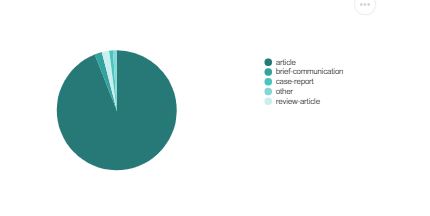
GRAPHIQUE-Diagramme circulaire
Routine utilisable
- distinct-by
- distinct-by-field
Paramétrage disponible
-Nombre max de champs
Nombre de champs maximum retourné par la routine, vide et équivalent à l’infini (si la routine le permet)
-Valeur minimum à afficher & Valeur maximum à afficher
Encadrement des valeur retourné par la routine, vide et équivalent à l’infini [-∞, +∞] (si la routine le permet)
-Trier par
Trie les données retournées par la routine sur leur intitulé ou leurs valeurs (si la routine le permet)
-Afficher l’info-bulle
permet de mettre une info-bulle sur les données du graphique avec un titre sur les intitulés et valeurs des données.
-Jeu de couleurs
Couleur du graphique donné en code hexadécimal
=> Exemple /api/run/distinct-by/YWUH
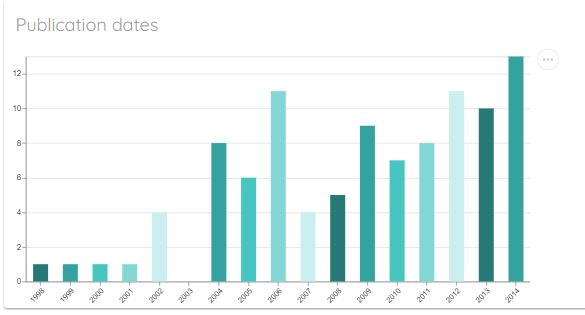
GRAPHIQUE-Diagramme en barres
Routine utilisable
- distinct-by
- distinct-by-field
Paramétrage disponible
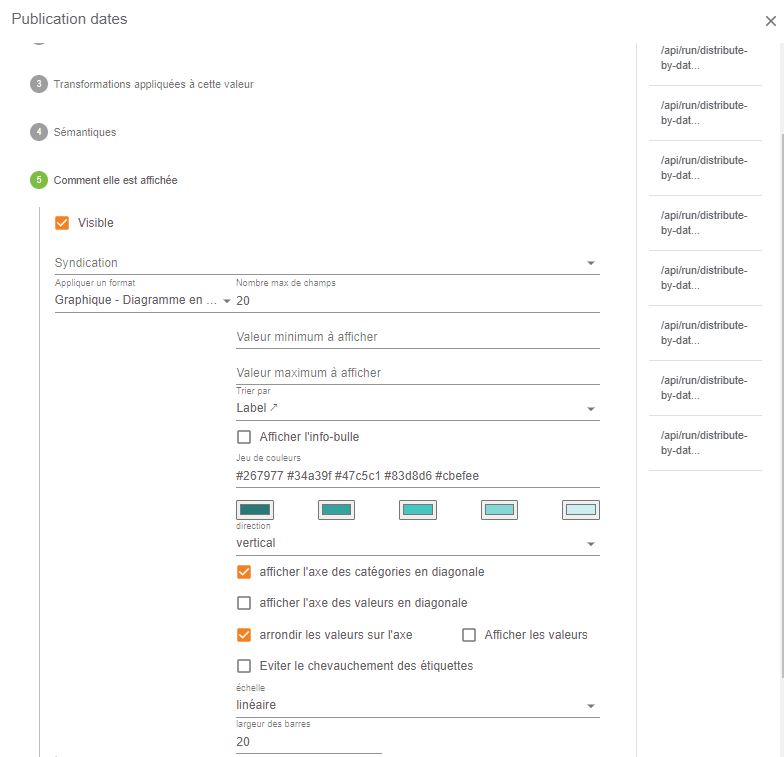
-Nombre max de champs
Nombre de champs maximum retourné par la routine, vide et équivalent à l’infini (si la routine le permet)
-Valeur minimum à afficher & Valeur maximum à afficher
Encadrement des valeurs retournées par la routine, vide et équivalent à l’infini [-∞, +∞] (si la routine le permet)
-Trier par
Trie les données retournées par la routine sur leur intitulé ou leurs valeur (si la routine le permet)
-Afficher l’info-bulle
Permet de mettre une info-bulle sur les données du graphique avec un titre sur les intitulés et valeurs des données.
-Jeu de couleurs
Couleur du graphique donné en code hexadécimal
-Direction
Direction des barres du graphique (barres horizontal ou vertical)
–Afficher l’axe des catégories en diagonale & Afficher l’axe des valeurs en diagonale
Passe l’angle des intitulé des axe de 0° à 45°
-Arrondir les valeurs sur l’axe
Arrondi les valeur de l’axe (sans virgule)
-Afficher les valeurs
Supprime l’axe des valeurs pour le remplacer par un affichage sur les barres
-Échelle
Type de représentation du graphique (linéaire ou logarithmique)
-Largeur des barres
Taille maximum des barres
=> Exemple /api/run/distribute-by-date/cb8a
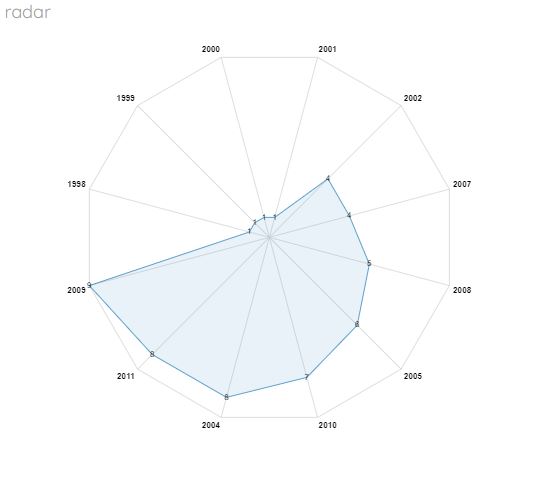
GRAPHIQUE-Diagramme radar
Routine utilisable
- distinct-by
- distinct-by-field
Paramétrage disponible
-Nombre max de champs
Nombre de champs maximum retourné par la routine, vide et équivalent à l’infini (si la routine le permet)
–Valeur minimum à afficher & Valeur maximum à afficher
Encadrement des valeurs retournées par la routine, vide et équivalent à l’infini [-∞, +∞] (si la routine le permet)
-Trier par
Trie les données retournées par la routine sur leur intitulé ou leurs valeur (si la routine le permet)
-Afficher l’info-bulle
Permet de mettre une info-bulle sur les données du graphique avec un titre sur les intitulés et valeurs des données.
-Couleur
Couleur du graphique donné en code hexadécimal
-Arrondir les valeurs sur l’axe
Arrondi les valeurs de l’axe
-Échelle
Type de représentation du graphique (linéaire ou logarithmique)

=> Exemple /api/run/distinct-by/cb8a
GRAPHIQUE-Graphe à bulles
Routine utilisable
- distinct-by
- distinct-by-field
Paramétrage disponible
-Nombre max de champs
Nombre de champs maximum retourné par la routine, vide et équivalent à l’infini (si la routine le permet)
-Valeur minimum à afficher & Valeur maximum à afficher
Encadrement des valeur retourné par la routine, vide et équivalent à l’infini [-∞, +∞] (si la routine le permet)
-Trier par
Trie les données retournées par la routine sur leur intitulé ou leurs valeurs (si la routine le permet)
-Jeu de couleurs
Couleur du graphique donné en code hexadécimal
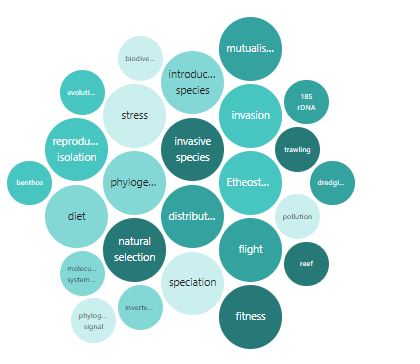
–Diamètre des bulles(nombre en px)
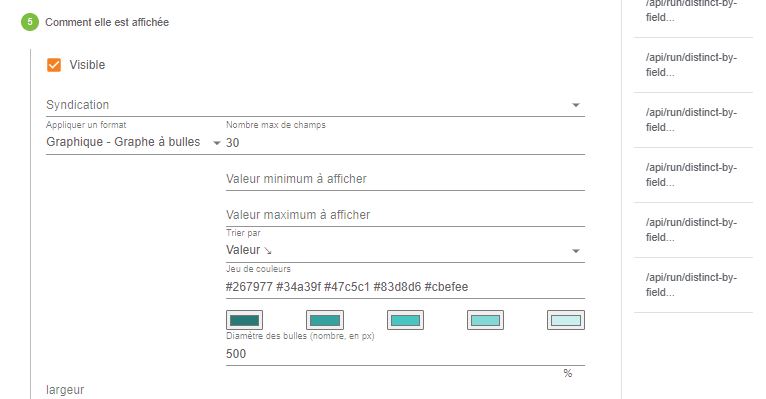
=> Exemple /api/run/distinct-by/sCRT
GRAPHIQUE-Graphique de flux
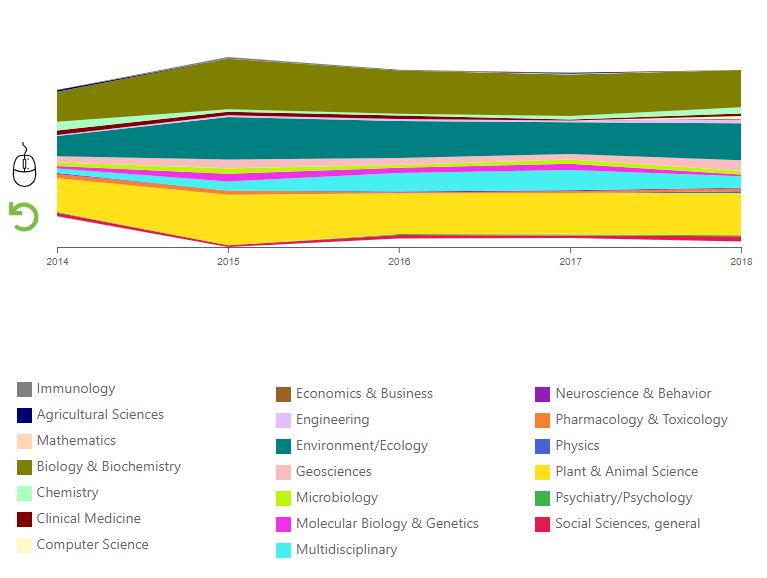
Travaille sur plusieurs champs monovalués ou multivalués, textuels ou numériques.
=> Exemple : Disciplines scientifiques des articles du jeu de donnée par année
Routine utilisable
- pairing-with
Paramétrage disponible
-Comment la valeur est créée
/api/run/pairing-with/zoQ1/mk4M/ (dans notre exemple zoQ1=Year et mk4M=Disciplines)
-Comment elle est affichée
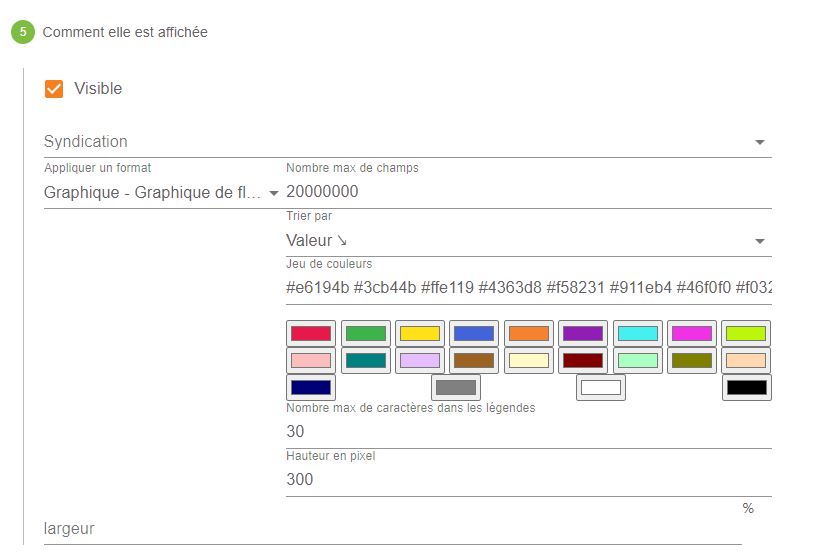
Prévoir autant de couleur qu’il existe de disciplines pour que le graphe soit lisible
GRAPHIQUE-Graphique hiérarchique
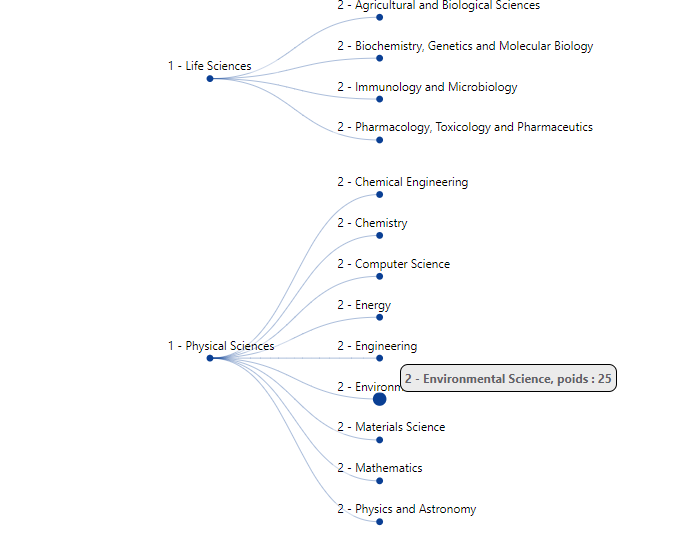
Ce format permet de créer des graphiques en forme d’arbres représentant des données hiérarchisées (classification, taxonomies …) et d’afficher le nombre de documents concernés.
Les valeurs du champ représenté sont listées dans un ordre précis : du plus générique au plus spécifique et concerne des noms des espèces ou des catégories scientifiques (termes les plus spécifiques d’une classification hiérarchique).
Routine utilisable
- tree-by
Paramétrage disponible
-Comment la valeur est créée
/api/run/tree-by/aRmn (dans notre exemple le champ aRmn est le champ de catégories scientifiques)
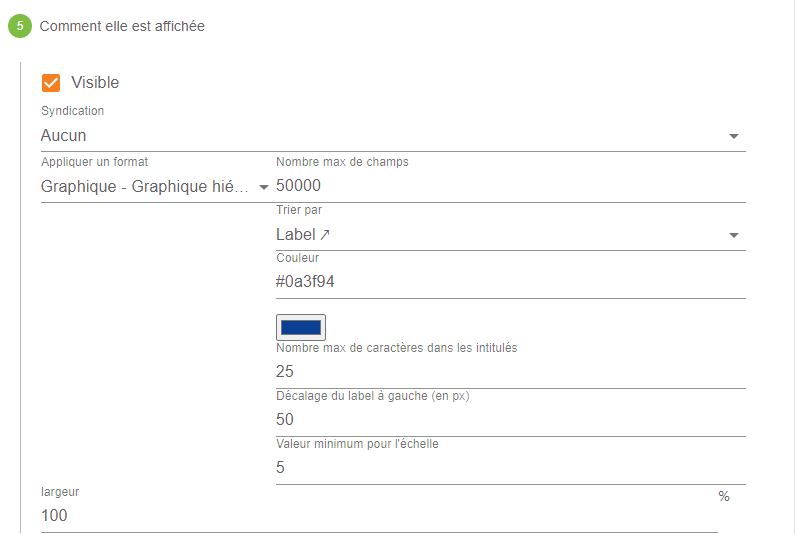
-Comment elle est affichée
Faire varier les champ pour rendre le graphe lisible.
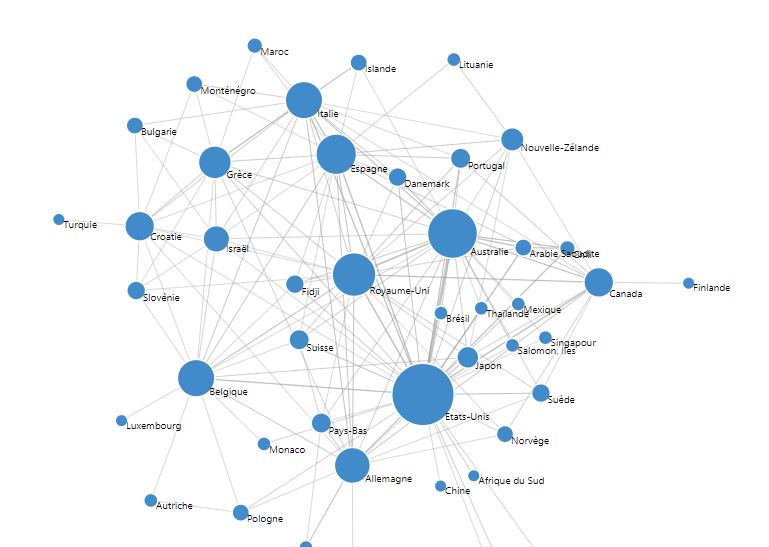
GRAPHIQUE-Réseaux
Permet de visualiser des réseaux comme par exemple les pays qui publient entre eux (dans affiliation)….
Routine utilisable
- decompose-by
Paramétrage disponible
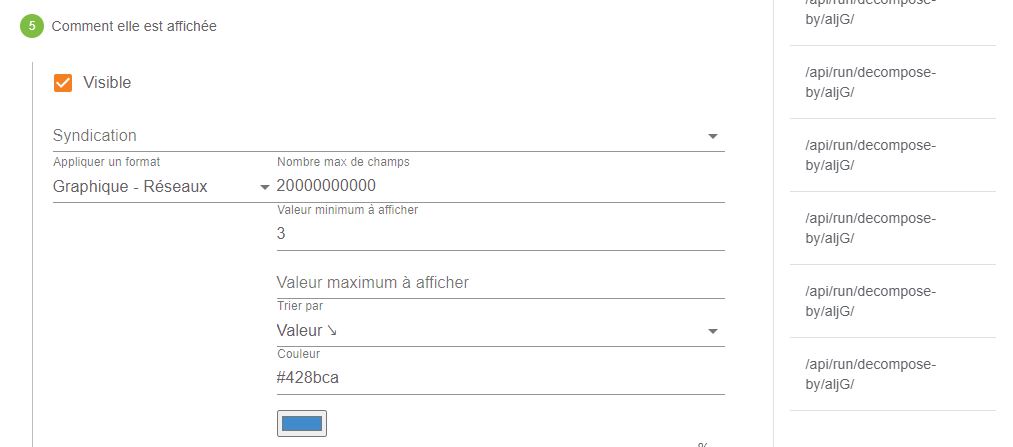
-Comment la valeur est créée
/api/run/decompose-by/aljG/(dans notre exemple aljG=Pays de publication)
-Comment elle est affichée
Faire varier les données pour avoir un graphe qui reste lisible.
GRAPHIQUE-Syntaxe Vega-Lite
Ce format permet de créer de nouveau graphique selon les besoins
Routine utilisable
- Cela dépend du graphique souhaité
Paramétrage disponible
-Nombre max de champs
Nombre de champs maximum retourné par la routine, vide et équivalent à l’infini (si la routine le permet)
-Valeur minimum à afficher & Valeur maximum à afficher
Encadrement des valeur retournées par la routine, vide et équivalent à l’infini [-∞, +∞] (si la routine le permet)
-Trier par
Trie les données retournées par la routine sur leur intitulé ou leurs valeurs (si la routine le permet)
Note : le tri par valeur peut ne pas fonctionner car il s’agit d’association de valeurs
-Spécification Vega-Lite
spécification qui peut être créé via le validateur vega
-Largeur responsive (optionnelle) [10~200]
Largeur du graphique correspondant à un pourcentage de la largeur de la fenêtre allant de 10 à 200 %
Si laissé vide alors les paramètres utilisé seront ceux donnés dans la spécification Vega-Lite
–Hauteur responsive (optionnelle) [10~800]
Hauteur du graphique correspondent à un pourcentage de 300px allant de 10 à 800%
Si laissé vide alors les paramètre utilisé seront ceux donnés dans la spécification Vega-Lite
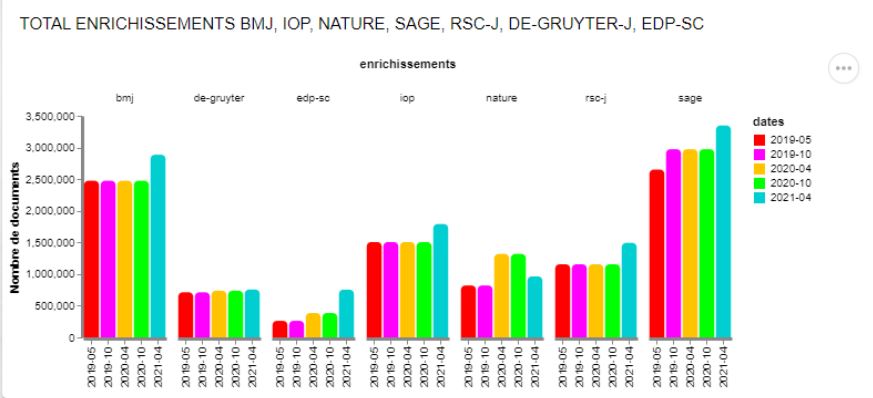
Exemple d’un graphe créé avec le format Vega-Lite : Nombre total d’enrichissements par corpus et sur plusieurs années
Routine utilisable
- select-by
pour un graphique construit avec des données chiffrées.Cette routine permet de lire les chiffres comme tels et les positionne dans un graphique sans en faire la somme.Le graphique peut avoir 2 ou 3 dimensions.
Pour obtenir le graphique à barres ci-dessous :
x = dates
y = nombre de documents
z = enrichissements
*Page de ressource
Créer un champ pour chaque donnée requise pour le graphique à l’aide de « +DEPUIS UNE COLONNE »
Exemple : Date ; Editeurs ; Nombre de documents ayant 1 enrichissement
Pour chaque champ.
1-Informations générales .Etiquette : écrire le nom du graphique
5-Décocher « visible »
Lodex attribue à chaque champ un identifiant à 4 caractères :
Exemple : Date = XuPz ; Editeurs = v4dJ ; Nombre de documents ayant 1 enrichissement = fI2J
*Page de graphiques
« + NOUVEAU CHAMP »
1- Informations générales .Etiquette : écrire le nom du graphique
2-Comment la valeur est créée => une valeur arbitraire =>/api/run/select-by/XuPz/v4dj/fl2J
Après avoir sélectionné la routine, ajouter les identifiants des 3 champs créés dans la Page de ressources (Attention à ne pas laisser d’espace avant ou après les identifiants)
L’identifiant positionné en 1ère position sera sur l’axe x, le second sur l’axe z et le 3ème sur l’axe y.
On peut ne sélectionner que 2 identifiants pour obtenir un graphique avec deux axes.
5-Comment elle est affichée
Dans « Appliquer un format » choisir « Graphique – Syntaxe Vega-Lite »
Le validateur vega est pré-rempli avec :
{« width »: 600, « autosize »: {« type »: « fit », « contains »: « padding » }, « mark »: « bar », « encoding »: { « x »: {« field »: « _id », « type »: « ordinal »}, « y »: {« field »: « value », « type »: « quantitative »} }, « data »: {« name »: « values »} }
Où l’intitulé de x est « _id » et l’intitulé de y est « value ».
Certaines modifications sont apportées pour obtenir le graphique ci-desus :
{ « autosize »: {« type »: « fit », « contains »: « padding »}, « spacing »: 8, « mark »: {« type »: »bar », « cornerRadiusEnd »: 4}, « encoding »: { « column »: {« field »: « value », « type »: « ordinal », « title »: « enrichissements »}, « y »: { « field »: « weight », « type »: « quantitative », « axis »: {« title »: « Nombre de documents », « grid »: false} }, « x »: { « field »: « _id », « type »: « nominal », « scale »: {« rangeStep »: 15}, « axis »: {« title »: « »} }, « color »: { « field »: « _id », « type »: « nominal », « scale »: { « range »: [« #FF0000 » , « #FF00FF » , « #FFC300 » , « #00FF00 » , « #00CED1 » , « #228B22 »] }, « axis »: {« title »: « dates »} }, « config »: { « view »: {« stroke »: « transparent »}, « axis »: {« domainWidth »: 3}, « style »: {« cell »: {« stroke »: « transparent »}} } }
- L’intitulé de x est « _id », l’intitulé de y est « weight » et l’intitulé de z est « value ».
- « color » permet d’ajouter des couleurs aux différentes barres du graphique, elles sont ici ajoutées aux données de « x » puisque c’est sur ce champ que sont configurées les dates).
- L’ajout de « title » permet de donner un titre aux différents champs : « axis »: {« title »: « dates »} ajoute un titre au code couleurs (« color ») qui concerne les données de « x » ; on laisse vide le « axis »: {« title »: « »} de « x », sinon le titre « dates » apparaîtrait en dessous de chaque groupe de dates.
- « cornerRadiusEnd » arrondit les angles des barres ; pour supprimer cette fonctionnalité, supprimer {« type »: »bar », « cornerRadiusEnd »: 4}, et le remplacer par « bar »,
Pour obtenir une infobulle qui indique le nombre d’enrichissements sur chaque barre du graphique, il faut ajouter :
{ « autosize »: {« type »: « fit », « contains »: « padding »}, « spacing »: 8, « mark »: {« type »: »bar », « cornerRadiusEnd »: 4}, « encoding »: { « column »: {« field »: « value », « type »: « ordinal », « title »: « enrichissements »}, « y »: {« field »: « weight », « type »: « quantitative », « axis »: {« title »: « Nombre de documents », « grid »: false} }, « x »: { « field »: « _id », « type »: « nominal », « scale »: {« rangeStep »: 15}, « axis »: {« title »: « »} }, « color »: { « field »: « _id », « type »: « nominal », « scale »: { « range »: [« #FFAC33 », « #00ff7b », « #33D4FF », « #E633FF », « #FF3342 », « #0000FF »] }, « axis »: {« title »: « dates »} }, « tooltip »: [ {« field »: « _id », « type »: « nominal », « title »: « »}, {« field »: « weight », « type »: « quantitative », « title »: « values »} ]}, « config »: { « view »: {« stroke »: « transparent »}, « axis »: {« domainWidth »: 3}, « style »: {« cell »: {« stroke »: « transparent »}} } }
Après publication on peut tester en cliquant sur les » petite points du graphe, puis en choisissant « Open in Vega Editor » d’autres modifications que l’on souhaiterait apporter.
Cliquer sur « Run » pour voir le graphique
On a la configuration que l’on a mise dans le validateur Vega à gauche et le graphique à droite.
Cette configuration est ici indentée, ce qui facilite sa lecture.
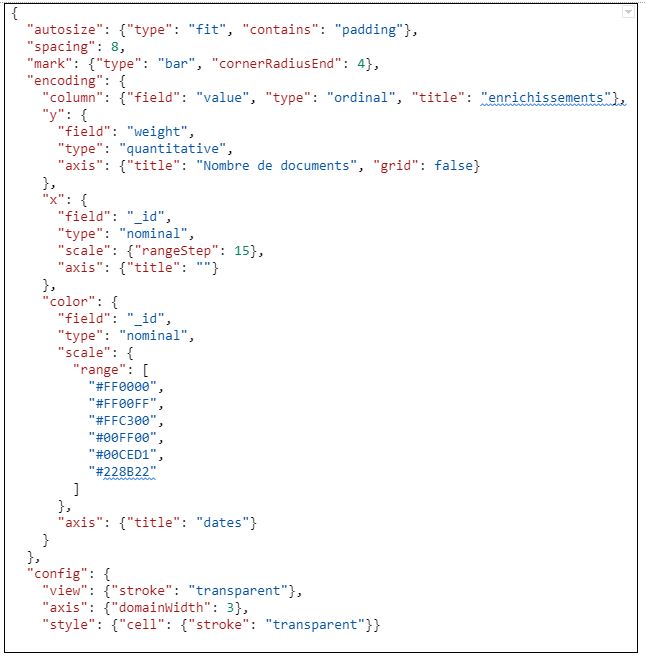
On peut voir s’opérer en direct sur le graphique les modifications que l’on apporte dans la configuration.
Il s’agit seulement d’une visualisation. Pour que les transformations soient effectives dans le graphique de l’instance, il faut copier la nouvelle configuration et la coller dans le validateur Vega du graphique.
Variation : Pour obtenir un graphique présentant les résultats chiffrés sur des lignes
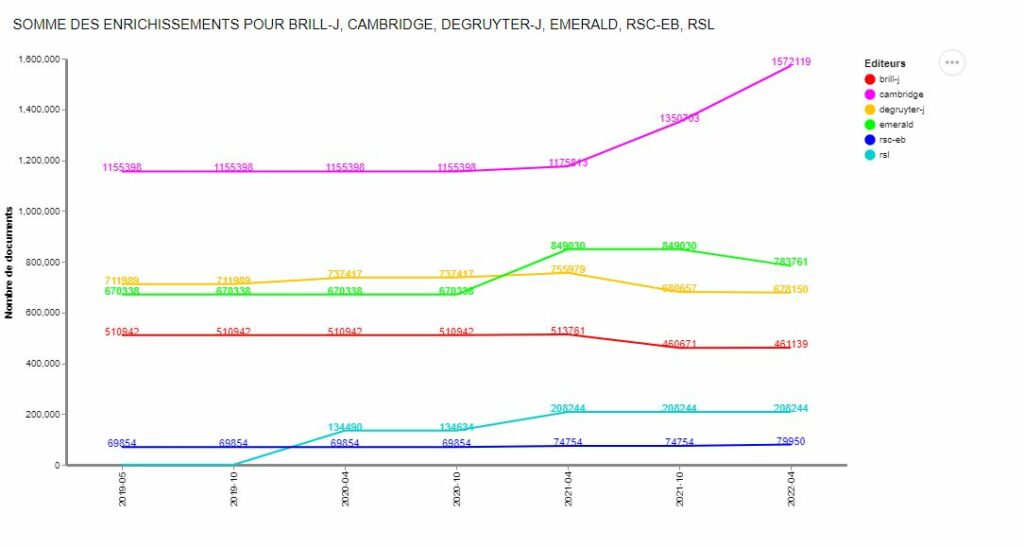
La procédure est la même. Le changement s’opère dans la configuration Vega :
{ « autosize »: {« type »: « fit », « contains »: « padding »}, « spacing »: 8, « layer »: [ { « mark »: « line », « encoding »: { « line »: {« field »: « value », « type »: « ordinal »}, « y »: { « field »: « weight », « type »: « quantitative », « axis »: {« title »: « Nombre de documents », « grid »: false} }, « x »: { « field »: « _id », « type »: « nominal », « axis »: {« title »: « »} }, « color »: { « field »: « value », « type »: « nominal », « scale »: {« range »: [« #FF0000 » , « #FF00FF » , « #FFC300 » , « #00FF00 » , « #0000FF », « #00CED1 » , « #228B22 »]}, « axis »: {« title »: « Editeurs »} } }, « layer »: [ {« mark »: {« type »: « line »}}, {« mark »: {« type »: « text », « dy »: « 15 »}, « encoding »: {« text »: {« field »: « weight », « type »: « nominal »}} } ]}], « config »: { « view »: {« stroke »: « transparent »}, « axis »: {« domainWidth »: 3}, « style »: {« cell »: {« stroke »: « transparent »}} } }
- Le « type »: « line » est encodé dans un « layer ».
- « dy »: « 15 » permet d’ajuster la distance entre les chiffres et la ligne ; le nombre peut être augmenté ou diminué pour éloigner ou rapprocher les chiffres de la ligne.